
企业智能知识库 Python 后端实战:FastAPI + RAG + KAG 企业级 AI 项目
📌 项目整体介绍(架构、技术栈、功能清单):企业智能知识库系统介绍
最近缺项目经历想快速提升项目实战能力(包含多个AI项目),或者最近找工作,或者想学习AI的小伙伴,可以看看下面👇🏻的这个链接(或许真的能够帮到你)。
一、项目概述
企业智能知识库 Python 后端是一套完整的企业级智能知识管理平台后端服务,基于 FastAPI 框架构建,采用模块化 APIRouter 架构,融合了文档管理、分布式文件存储、全文检索、人工智能(RAG/KAG)、知识图谱等前沿技术,为企业提供从文档创建、存储、检索、共享到智能问答的全链路知识管理解决方案。
1.1 项目定位
| 维度 | 说明 |
|---|---|
| 项目类型 | 企业级智能知识管理平台 |
| 架构模式 | 模块化单体(Module-based Monolith) |
| 后端技术 | FastAPI + Python 3.12+ + SQLAlchemy 2.0 |
| 数据库 | MySQL 8.0 × 9 + Redis + Elasticsearch + MongoDB + Neo4j |
| 消息队列 | RabbitMQ + Celery |
| 文件存储 | S3 兼容(MinIO / RustFS) |
| AI 能力 | LLM 对话 + RAG 检索增强生成 + KAG 知识增强生成 |
1.2 系统架构图
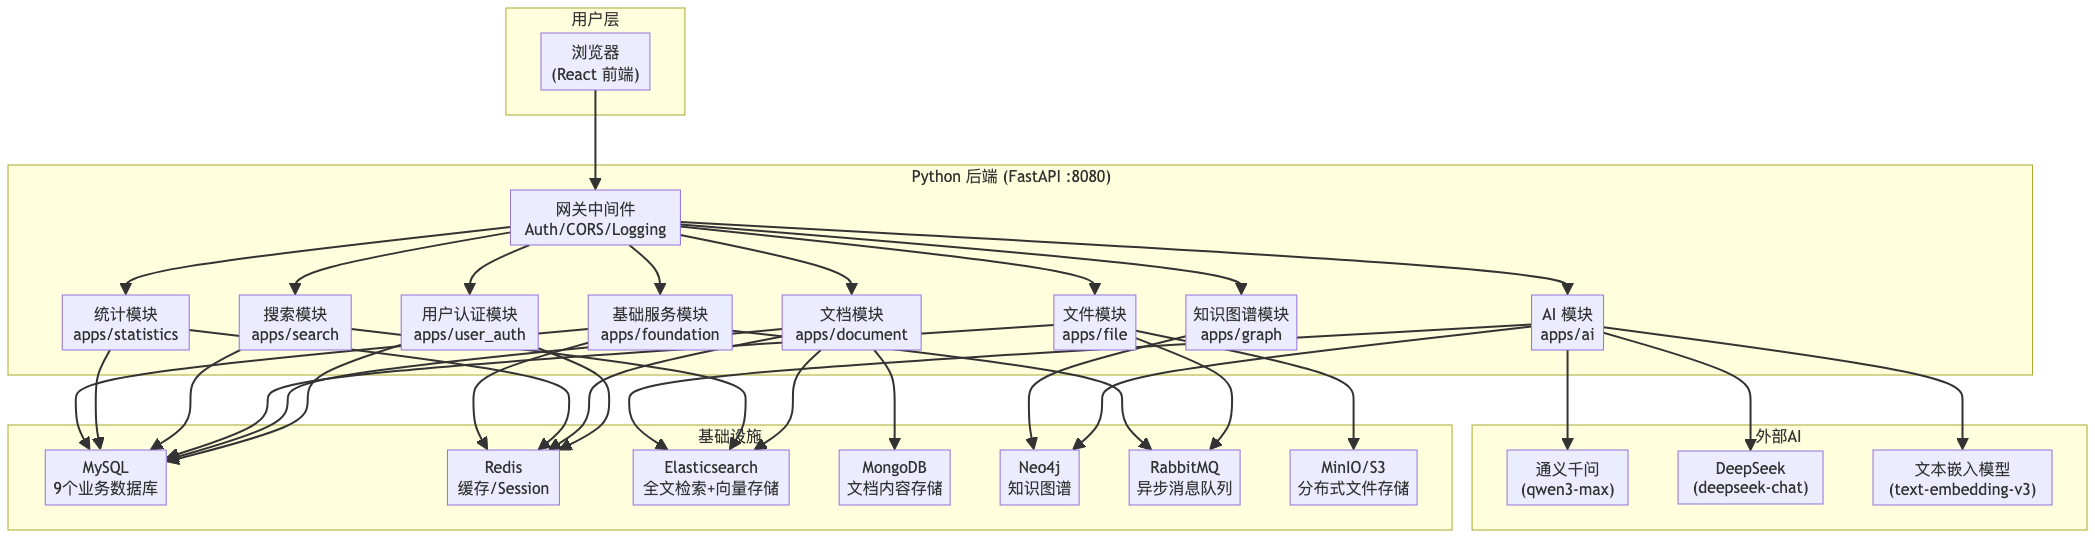
二、项目架构
2.1 模块化单体架构
项目采用**模块化单体(Module-based Monolith)**架构——单一进程运行,内部按业务域拆分为独立的 apps/ 模块,通过 FastAPI 的 APIRouter 机制实现路由隔离。
┌──────────────────────────────────────┐
│           FastAPI Application         │
│              (主进程 :8080)            │
│                                       │
│  ┌──────────┐  ┌──────────┐          │
│  │ Gateway  │  │   CORS   │  中间件   │
│  │ Auth     │  │  Logger  │          │
│  └──────────┘  └──────────┘          │
│                                       │
│  ┌──────────────┐  ┌──────────────┐  │
│  │ apps/        │  │ apps/        │  │
│  │ user_auth    │  │ document     │  │
│  │ ┌──────────┐ │  │ ┌──────────┐ │  │
│  │ │ schemas  │ │  │ │ schemas  │ │  │
│  │ │ services │ │  │ │ services │ │  │
│  │ │ routers  │ │  │ │ routers  │ │  │
│  │ │ models   │ │  │ │ models   │ │  │
│  │ └──────────┘ │  │ └──────────┘ │  │
│  └──────────────┘  └──────────────┘  │
│                                       │
│  ┌──────────────┐  ┌──────────────┐  │
│  │ apps/file    │  │ apps/search  │  │
│  └──────────────┘  └──────────────┘  │
│                                       │
│  ┌──────────────┐  ┌──────────────┐  │
│  │ apps/ai      │  │ apps/graph   │  │
│  └──────────────┘  └──────────────┘  │
│                                       │
│  ┌──────────────┐  ┌──────────────┐  │
│  │ apps/        │  │ apps/        │  │
│  │ foundation   │  │ statistics   │  │
│  └──────────────┘  └──────────────┘  │
│                                       │
│  ┌────────────────────────────────┐  │
│  │          common/               │  │
│  │  database | redis | mongo      │  │
│  │  rabbitmq | security | ...     │  │
│  └────────────────────────────────┘  │
└──────────────────────────────────────┘
架构优势:
- 部署简单:一个进程即整个后端,无需服务注册中心
- 启动快:冷启动秒级完成
- 调试方便:单进程调试,所有模块在同一上下文
- 可演化:未来可按
apps/边界平滑拆分为独立微服务
2.2 模块清单
| 模块 | 目录 | 核心职责 |
|---|---|---|
| gateway | apps/gateway/ | 统一入口、路由重写、CORS、JWT 认证白名单、请求日志 |
| common | common/ | 共享基础设施:数据库管理、Redis、MongoDB、RabbitMQ、JWT、雪花 ID |
| user_auth | apps/user_auth/ | 用户认证、角色权限(RBAC)、团队管理、菜单管理 |
| document | apps/document/ | 文档 CRUD、分类标签、评论审核、版本管理、收藏分享、PDF 导出 |
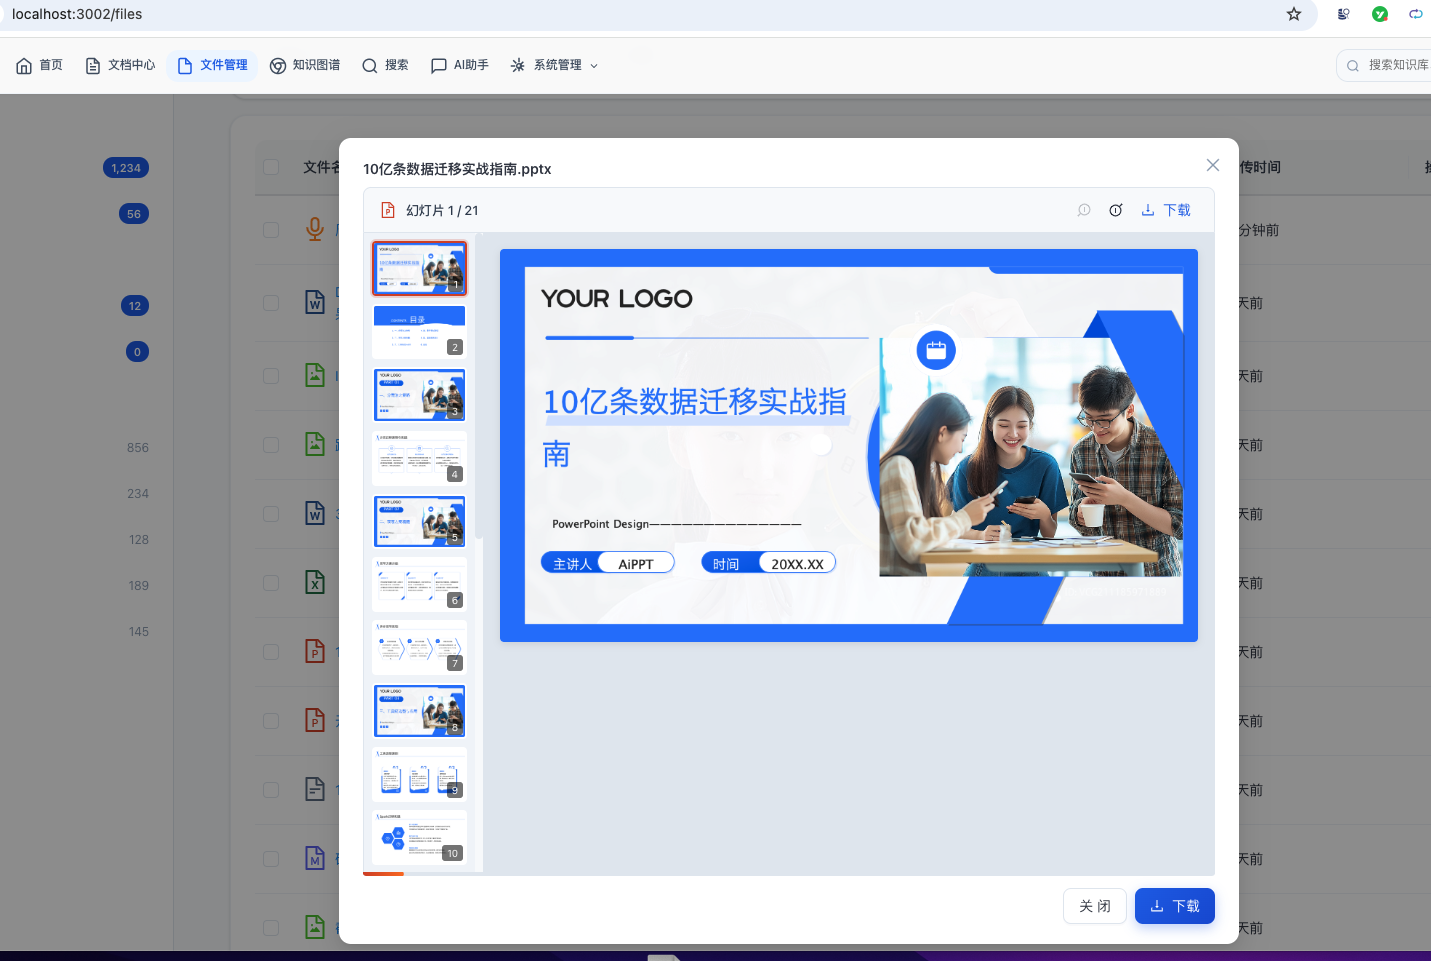
| file | apps/file/ | 文件上传下载、S3 存储、文件预览 |
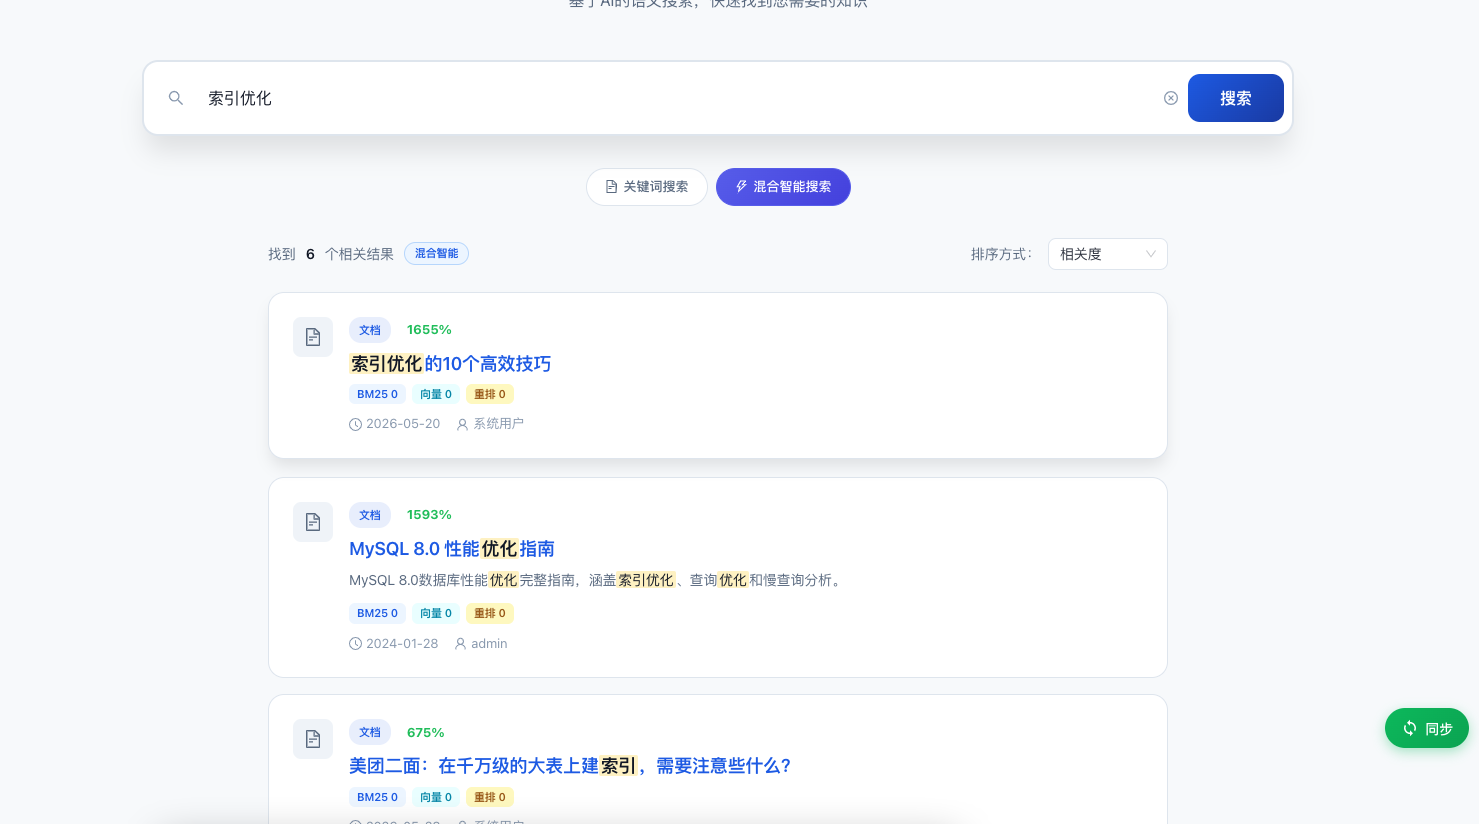
| search | apps/search/ | 全文检索、混合搜索(BM25+向量)、搜索历史 |
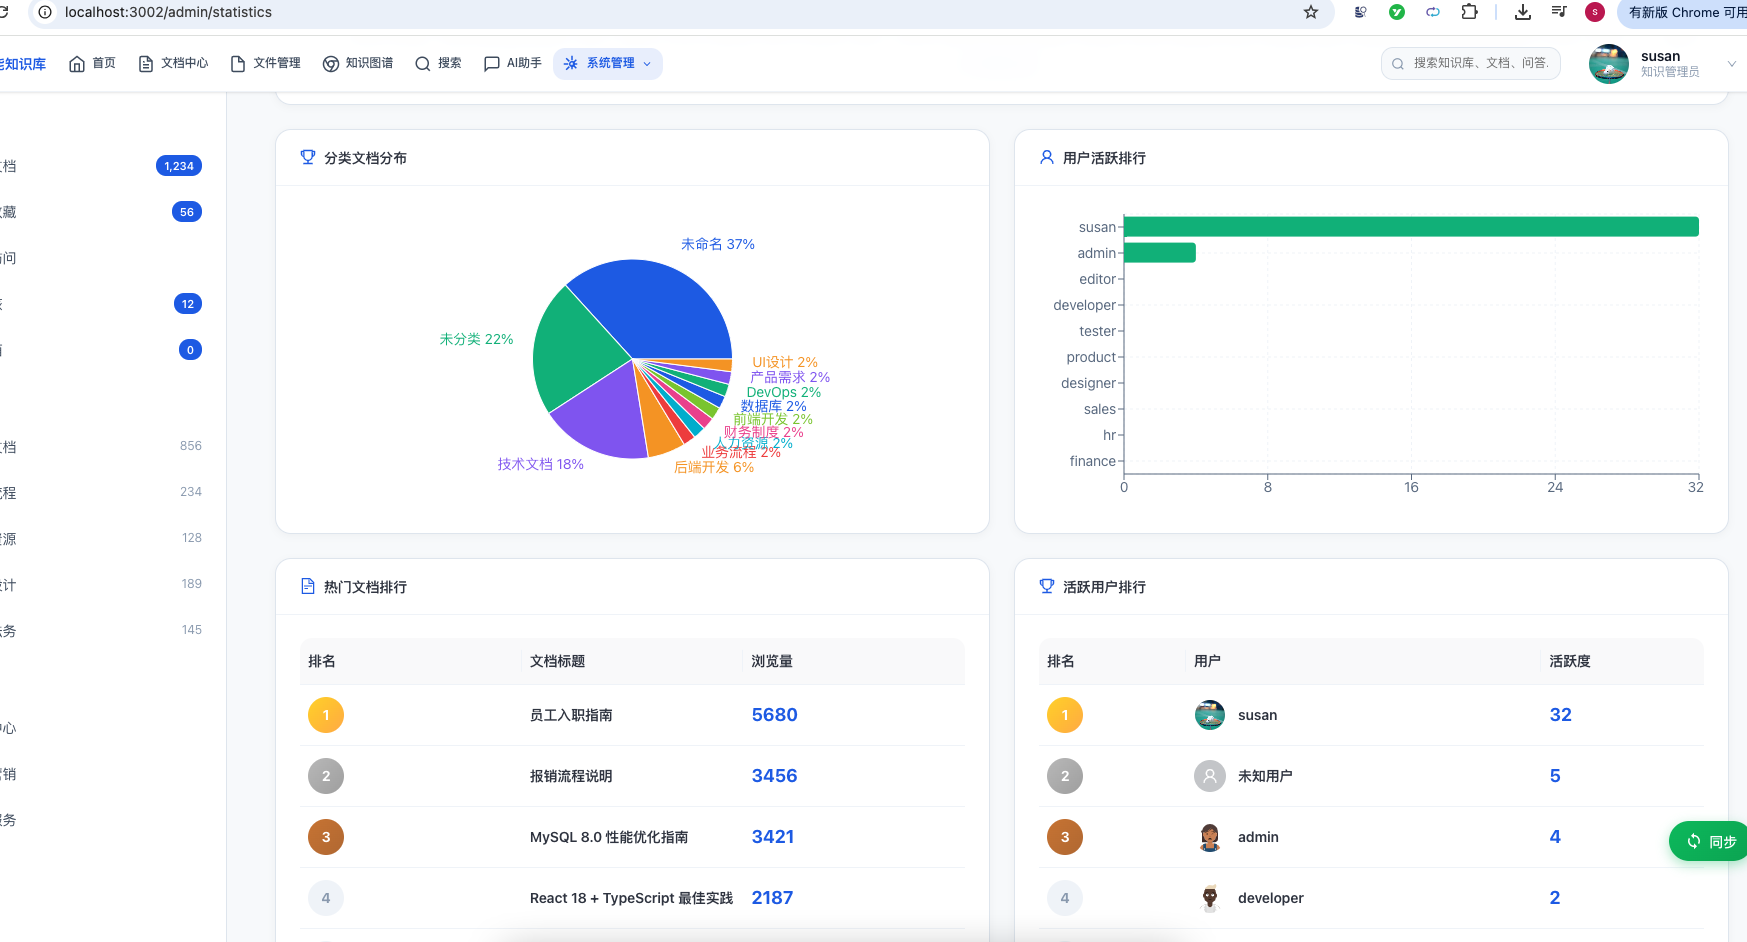
| statistics | apps/statistics/ | 系统统计、数据概览、趋势分析 |
| graph | apps/graph/ | 知识图谱:实体关系、路径分析、社区发现 |
| foundation | apps/foundation/ | 系统配置、字典管理、操作日志、WebSocket 通知推送 |
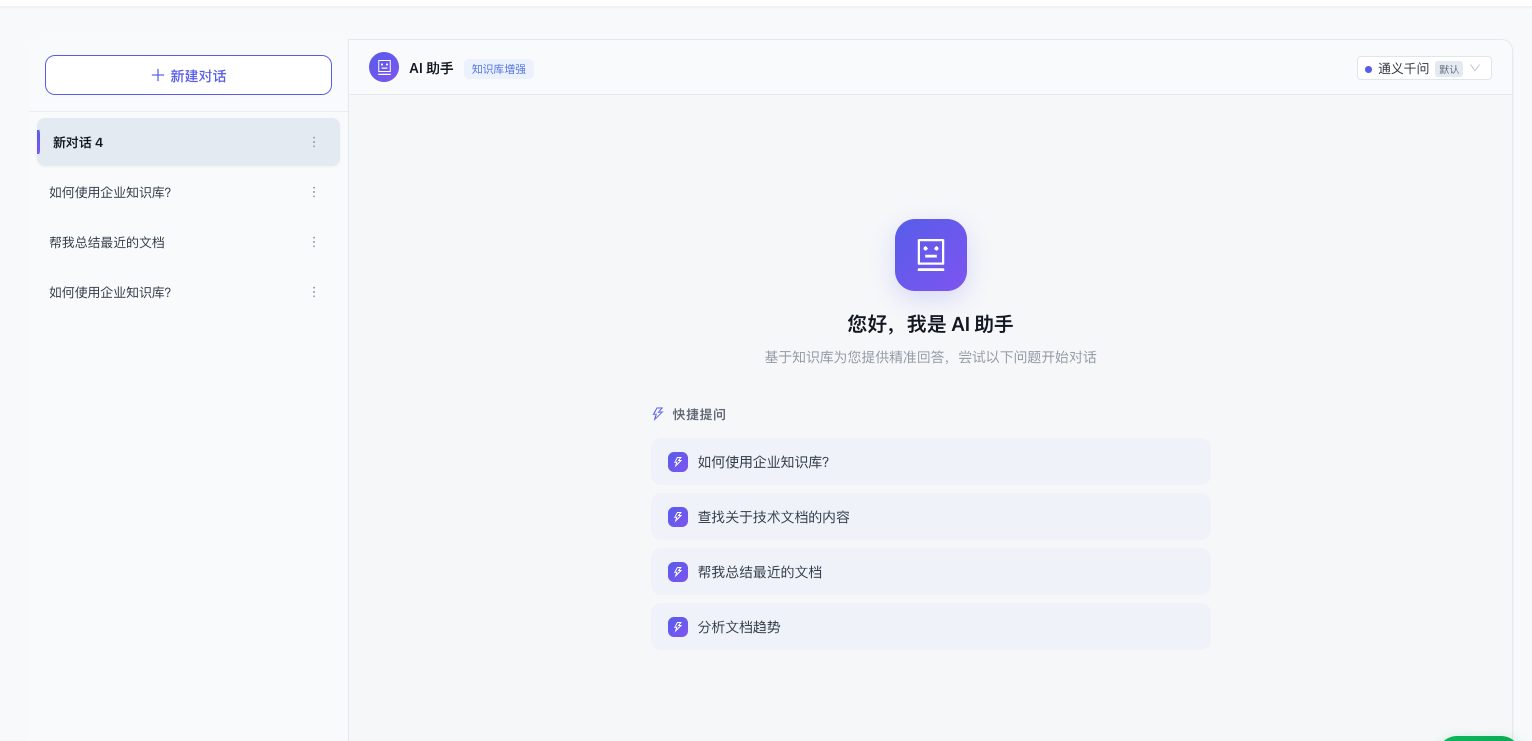
| ai | apps/ai/ | AI 对话、RAG 问答、KAG 知识增强、AI 写作、文档智能 |
2.3 技术选型
| 技术栈 | 版本 | 用途 |
|---|---|---|
| FastAPI | >=0.115 | Web 框架 |
| Uvicorn | >=0.30 | ASGI 服务器 |
| SQLAlchemy 2.0 | >=2.0 | ORM(异步) |
| asyncmy | >=0.2.9 | MySQL 异步驱动 |
| Alembic | >=1.13 | 数据库迁移 |
| Redis (hiredis) | >=5.0 | 缓存 |
| Elasticsearch (async) | >=8.0 | 全文检索 |
| Motor + PyMongo | >=3.5 | MongoDB 异步客户端 |
| Neo4j | >=5.20 | 知识图谱 |
| aio-pika | >=9.4 | RabbitMQ AMQP |
| Celery | >=5.4 | 异步任务队列 |
| python-jose | >=3.3 | JWT 处理 |
| passlib (bcrypt) | >=1.7 | 密码哈希 |
| boto3 / aioboto3 | >=1.34 | S3 存储 |
| python-docx | >=1.0 | Word 文档解析 |
| openpyxl | >=3.1 | Excel 解析 |
| pymupdf | >=1.24 | PDF 解析 + Markdown 转换 |
| weasyprint | >=60.0 | PDF 导出 |
| loguru | >=0.7 | 日志 |
| pydantic v2 | >=2.0 | 数据校验 + 配置管理 |
| httpx | >=0.27 | HTTP 客户端 |
三、数据库设计
3.1 数据库分布
| 数据库 | 所属模块 | 核心表 |
|---|---|---|
kb_user | user_auth | user, role, permission, team, menu |
kb_document | document | document, category, tag, comment, review, version, favorite, share |
kb_search | search | search_history, search_index_config |
kb_file | file | file_info, file_category |
kb_ai | ai | ai_conversation, ai_message, ai_feedback, ai_prompt_template |
kb_statistics | statistics | dashboard_config, statistics_snapshot |
kb_graph | graph | graph_node, graph_relation, graph_config |
kb_foundation | foundation | sys_config, sys_dict, operation_log, notification |
kb_common | 全局共享 | 通用配置与跨库视图 |
3.2 扩展存储
| 存储 | 用途 |
|---|---|
MongoDB (knowledge_base) | 文档正文内容(document_content)、编辑器自动保存历史(auto_save_history) |
| Elasticsearch | 文档全文索引 + 向量嵌入存储 |
| Neo4j | 知识图谱实体节点与关系 |
| MinIO / S3 | 上传文件与图片存储 |
3.3 数据库连接管理
common/database.py 实现了 DatabaseManager 单例,统一管理 9 个 MySQL 数据库的异步连接池:
- 惰性初始化:引擎在首次访问时创建,避免启动阻塞
- 连接池配置:
pool_size=10,max_overflow=20,pool_pre_ping=True,pool_recycle=3600s - 异步驱动:使用
asyncmy实现真正的异步 I/O
四、核心功能模块
4.1 网关中间件(apps/gateway)
网关中间件负责请求的预处理和路由分发:
| 功能 | 实现 |
|---|---|
| 路径重写 | GatewayPathRewriter 中间件,兼容 /api/xxx 路由前缀,前端无需感知后端子路径 |
| CORS | 全局跨域配置,支持 * 或指定域名 |
| JWT 认证 | AuthMiddleware,白名单路径(17 个公开端点)跳过校验 |
| 请求日志 | LoggingMiddleware,记录请求方法、路径、状态码、耗时 |
4.2 用户认证与权限(apps/user_auth)
- 认证:JWT 双 Token 机制,access_token(2 小时)+ refresh_token(7 天),HS256 签名
- 密码:BCrypt 哈希加密存储
- 权限:用户 → 角色 → 权限 三层 RBAC 模型
- 预设角色:超级管理员 / 管理员 / 编辑者 / 审阅者 / 普通用户 / 只读用户
- 团队:用户可归属多个团队,支持团队级别的协作
4.3 文档管理(apps/document)
覆盖文档全生命周期:
创建 → 编辑 → 提交审核 → 审核 → 通过 → 发布 → 归档
  ↑                ↓
  └── 拒绝(返回编辑)──┘
核心功能:
- 文档 CRUD:标题、正文(Markdown)、分类、标签、封面图
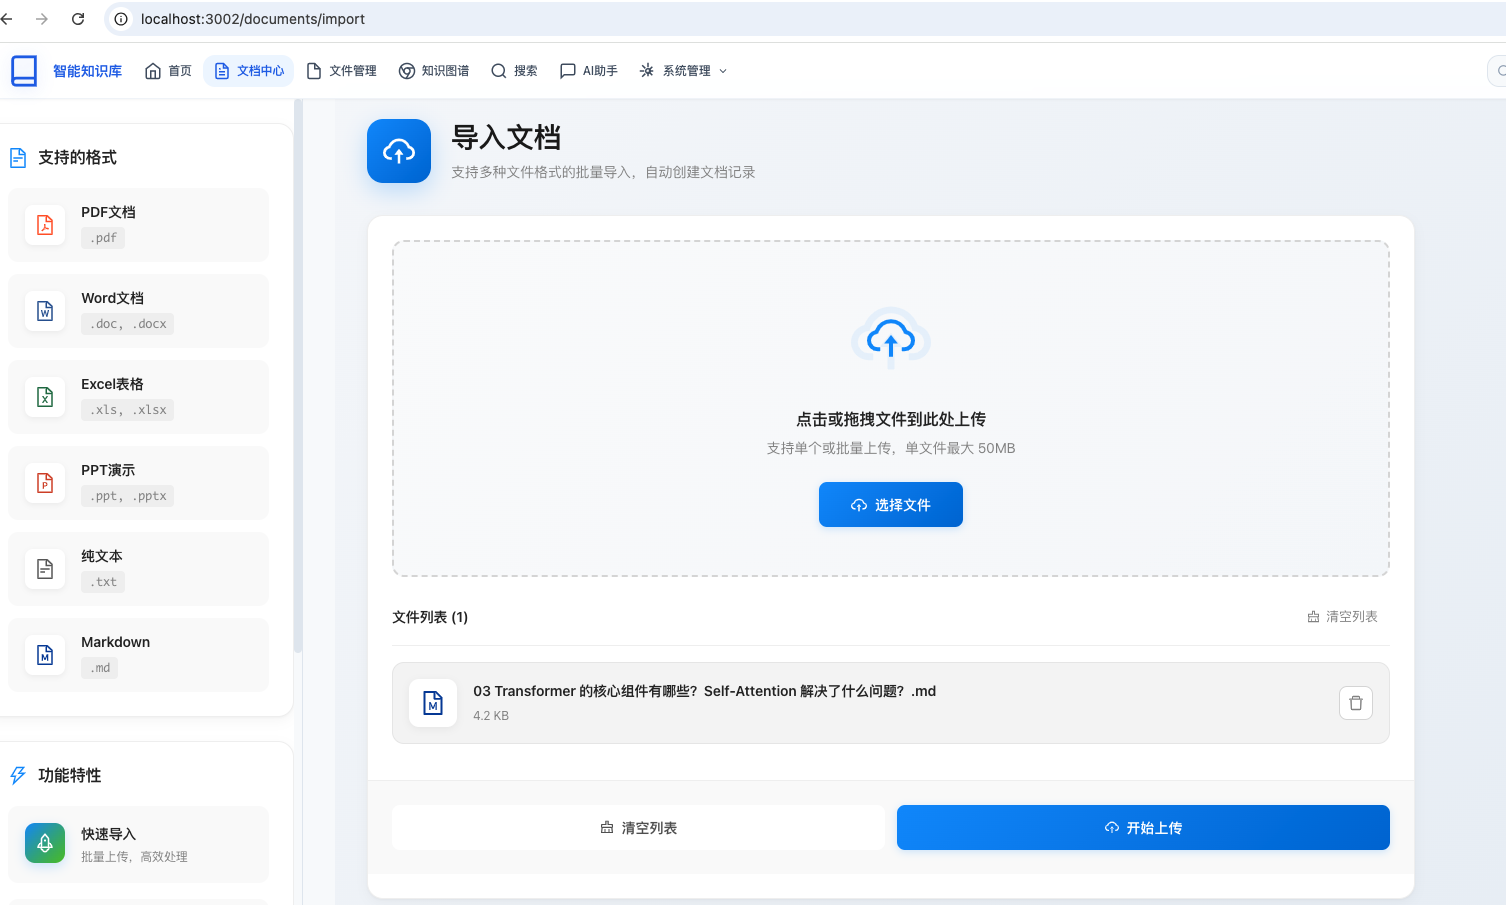
- 文件导入解析:上传 PDF / DOCX / XLSX 自动转换为 Markdown
- PDF:基于 pymupdf,支持文本提取、标题层级检测、表格识别、图片提取上传 S3、代码块检测、粗体/等宽字体样式分析
- DOCX:基于 python-docx,支持段落样式映射、内联格式(粗体/斜体)、表格转换
- XLSX:基于 openpyxl,工作表 → Markdown 表格
- PDF 导出:基于 weasyprint,Markdown 正文 → 专业排版 PDF,支持标题、代码块、表格、图片、粗体/斜体
- 版本管理:每次修改自动生成快照版本,支持版本对比和回滚
- 评论与审核:行内评论、审核工作流(提交 → 审批 → 通过/拒绝)
- 自动保存:编辑器内容定时保存到 MongoDB,防止意外丢失
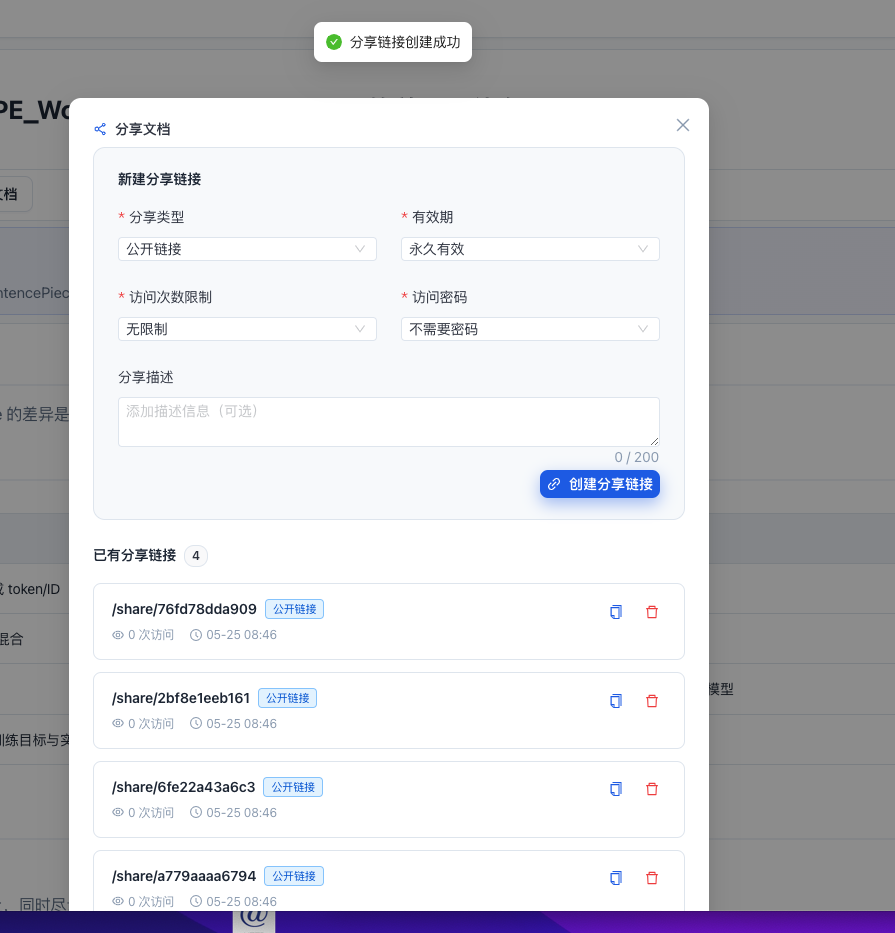
- 收藏与分享:个人收藏管理、生成分享链接
4.4 文件管理(apps/file)
- S3 兼容存储:支持 MinIO / RustFS / AWS S3,通过
S3Storage抽象层切换 - 文件上传:multipart 上传,自动生成带日期路径的对象 Key(如
images/pdf/2026/06/29/xxx.png) - 图片处理:集成 Pillow,支持缩略图生成
- 文件预览:在线预览常见文档、图片格式
4.5 智能搜索(apps/search)
- 全文检索:基于 Elasticsearch 倒排索引
- BM25 + 向量混合检索:关键词匹配 + 语义相似度双路并行
- RRF 融合排序:Reciprocal Rank Fusion 算法合并多路结果
- 搜索历史:用户搜索记录管理,支持热门搜索词推荐
4.6 AI 智能服务(apps/ai)
- 多模型接入:支持通义千问(Qwen)、DeepSeek,通过 OpenAI 兼容接口统一调用
- RAG 检索增强生成:文档分块 → 向量嵌入 → 混合检索 → 重排序 → LLM 生成,全链路异步
- KAG 知识增强生成:结合知识图谱的实体关系增强推理能力
- AI 对话:多轮对话,SSE 流式输出
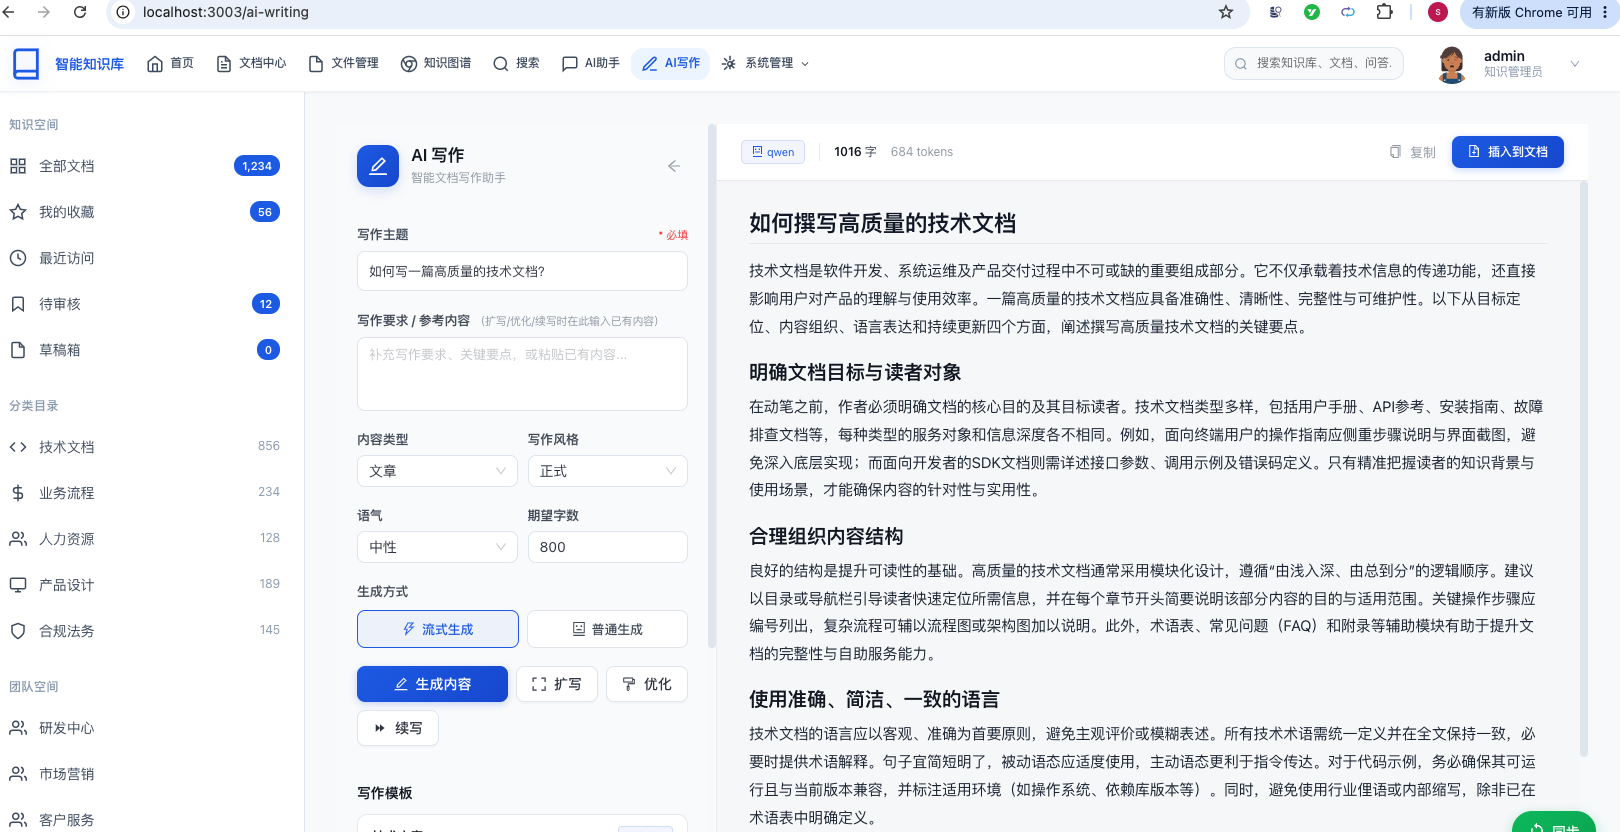
- AI 写作:模板驱动的文档自动生成,支持大纲扩展、段落续写
- 文档智能:自动摘要、关键词提取、实体识别
- 4 级降级策略:主模型 → 重试 → 备用模型 → 兜底响应,保障可用性
4.7 知识图谱(apps/graph)
- Neo4j 图存储:实体节点 + 关系边,灵活表达知识关联
- LLM 实体抽取:AI 自动识别文档中的实体和关系,自动构建图谱
- 图查询:最短路径、社区发现、相似实体推荐
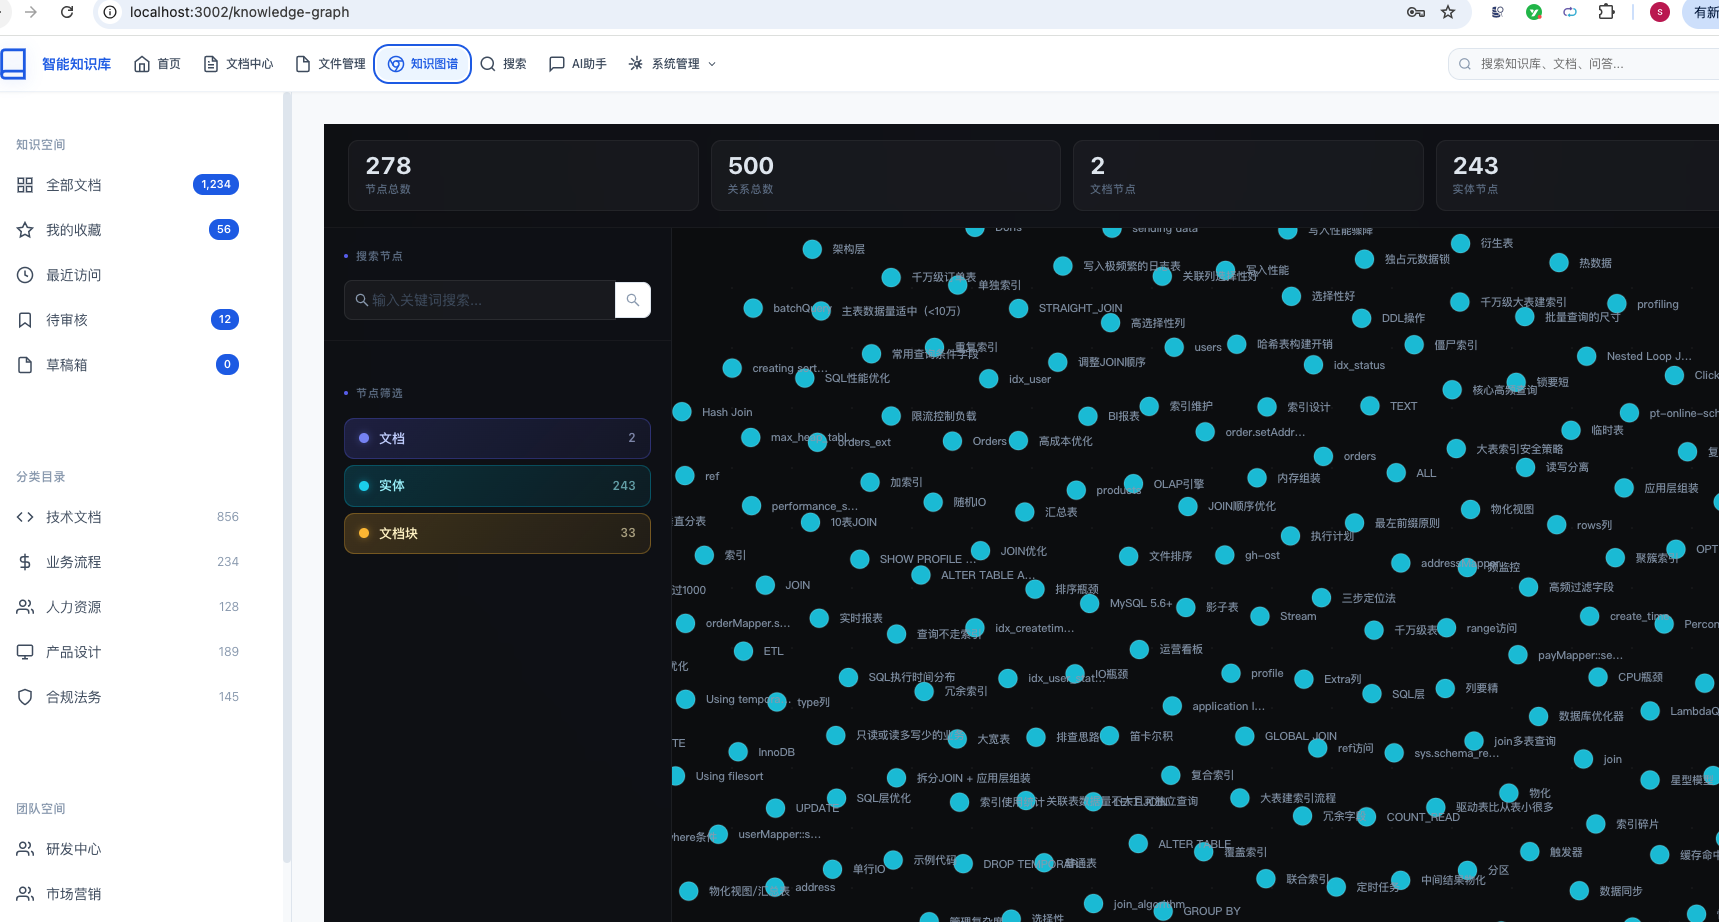
- 可视化:图数据 JSON 格式输出,前端 D3.js / ECharts 渲染
4.8 基础服务(apps/foundation)
- 系统配置:全局配置项管理(键值对),支持分组和热更新
- 字典管理:枚举值字典(类型 + 选项),系统各处统一引用
- 操作日志:全链路操作审计,记录用户、操作、参数、时间
- WebSocket 通知:实时消息推送(
/ws/notification),支持审核通知、系统消息等
4.9 统计分析(apps/statistics)
- 仪表盘:系统概览数据(文档总数、用户数、存储量等)
- 趋势分析:文档增长趋势、用户活跃度变化
- 热点数据:热门文档、高频搜索词、活跃用户排行
五、通用基础设施(common/)
5.1 组件清单
| 模块 | 功能 |
|---|---|
database.py | 9 个 MySQL 库的异步连接池管理,惰性初始化 |
redis.py | Redis 单例连接池(连接池大小 50),JWT 缓存、验证码存储 |
mongo.py | MongoDB Motor 异步客户端,惰性初始化 |
rabbitmq.py | RabbitMQ aio-pika 异步连接,Topic Exchange 声明 |
security.py | JWT HS256 Token 创建/校验/刷新,BCrypt 密码哈希 |
id_generator.py | 64 位雪花算法 ID,41 位时间戳 + 12 位序列号 |
base_model.py | SQLAlchemy ORM 基类,时间戳混入、软删除混入、审计混入 |
result.py | Result[T] 泛型统一响应格式 |
exceptions.py | 业务异常定义 + 全局异常处理器 |
deps.py | FastAPI 依赖注入(当前用户、权限校验、分页参数) |
json_response.py | 长整型安全的 JSON 响应(防止前端精度丢失) |
serializer.py | 模型序列化工具 |
enums.py / constants.py | 枚举定义 + 应用常量 |
5.2 关键设计
异步优先:所有外部 I/O(MySQL、Redis、MongoDB、ES、RabbitMQ、S3)均使用 async/await,单进程即可高效处理高并发。
雪花算法 ID:64 位分布式唯一 ID,起始时间戳 2024-01-01,数据中心 ID 为 1,每毫秒最多 4096 个 ID,具备时钟回拨容忍。
统一响应格式:所有 API 返回 Result[T] 格式:
{
  "code": 200,
  "message": "success",
  "data": { ... }
}
六、API 端点概览
6.1 端点分布
| 模块 | 路由前缀 | 主要端点 |
|---|---|---|
| user_auth | /api/auth, /api/users, /api/roles, /api/permissions, /api/teams, /api/menus | 登录、注册、Token 刷新、用户/角色/权限/团队/菜单 CRUD |
| document | /api/documents, /api/categories, /api/tags, /api/comments, /api/reviews | 文档 CRUD、分类、标签、评论、审核、版本、收藏、分享、上传解析、PDF 导出 |
| file | /api/files | 文件上传、下载、预览、分类管理 |
| search | /api/search | 关键词搜索、混合搜索、搜索历史、索引重建 |
| statistics | /api/statistics | 仪表盘、趋势、热点数据 |
| graph | /api/graph | 节点、关系、路径、社区、图谱构建 |
| foundation | /api/configs, /api/dicts, /api/logs, /api/notifications | 系统配置、字典、操作日志、通知管理 |
| ai | /api/ai | 对话、RAG 问答、KAG 推理、AI 写作、文档智能 |
| WebSocket | /ws/notification | 实时通知推送 |
最近缺项目经历想快速提升项目实战能力(包含多个AI项目),或者最近找工作,或者想学习AI的小伙伴,可以看看下面👇🏻的这个链接(或许真的能够帮到你)。
6.2 API 文档
服务启动后可通过以下地址访问交互式 API 文档:
- Swagger UI:http://127.0.0.1:8080/doc.html
- OpenAPI JSON:http://127.0.0.1:8080/openapi.json
七、项目目录结构
knowledge-base-python/
├── main.py                          # 应用入口(FastAPI 实例 + 生命周期管理)
├── config.py                        # 全局配置(pydantic-settings,从 .env 加载)
├── pyproject.toml                   # 项目元数据 + 依赖声明
├── uv.lock                          # UV 依赖锁定文件
├── docker-compose.yml               # 基础设施容器编排
├── .env.example                     # 环境变量模板
├── .gitignore
├── alembic.ini                      # 数据库迁移配置
│
├── common/                          # 共享基础设施(13 个模块)
│   ├── database.py                  # 9 个 MySQL 库的连接池管理
│   ├── redis.py                     # Redis 管理器
│   ├── mongo.py                     # MongoDB 管理器
│   ├── rabbitmq.py                  # RabbitMQ 管理器
│   ├── security.py                  # JWT + BCrypt 密码
│   ├── id_generator.py              # 雪花算法 ID 生成器
│   ├── base_model.py                # ORM 基类
│   ├── result.py                    # Result[T] 统一响应
│   ├── exceptions.py                # 业务异常 + 全局异常处理器
│   ├── deps.py                      # 依赖注入
│   ├── json_response.py             # 长整型安全 JSON
│   ├── serializer.py                # 序列化工具
│   └── enums.py / constants.py       # 枚举与常量
│
├── apps/                            # 业务模块(微服务风格目录)
│   ├── gateway/                     # 网关中间件
│   │   └── middleware.py
│   │
│   ├── user_auth/                   # 用户认证(RBAC)
│   │   ├── schemas/                 # Pydantic 请求/响应模型
│   │   ├── services/                # 业务逻辑层
│   │   ├── routers/                 # API 路由
│   │   └── models.py                # SQLAlchemy ORM 模型
│   │
│   ├── document/                    # 文档管理
│   │   ├── schemas/
│   │   ├── services/
│   │   │   ├── document_service.py      # 文档 CRUD + 工作流
│   │   │   ├── file_parser_service.py   # PDF/DOCX/XLSX → Markdown
│   │   │   └── pdf_export_service.py    # Markdown → PDF
│   │   ├── routers/
│   │   └── models.py
│   │
│   ├── file/                        # 文件管理
│   │   ├── schemas/
│   │   ├── services/
│   │   ├── routers/
│   │   ├── models.py
│   │   └── storage.py               # S3 存储抽象
│   │
│   ├── search/                      # 搜索服务
│   ├── graph/                       # 知识图谱
│   ├── foundation/                  # 基础服务 + WebSocket
│   ├── statistics/                  # 统计分析
│   └── ai/                          # AI 智能服务
│
├── alembic/                         # 数据库迁移
├── scripts/                         # 工具脚本
├── docs/                            # 项目文档
└── sql/                             # 数据库初始化脚本
八、技术亮点
8.1 全异步 I/O
所有外部调用(MySQL、Redis、MongoDB、ES、RabbitMQ、S3)均使用 Python async/await 异步驱动,单进程即可处理高并发请求,资源利用率远高于线程模型。
8.2 模块化设计
每个 apps/ 模块自包含三层架构(schemas / services / routers),可独立开发、测试,未来可平滑拆分为独立微服务。
8.3 PDF/DOCX/XLSX 智能文件解析
file_parser_service.py 实现了完整的二进制文件 → Markdown 转换管道:
| 格式 | 解析引擎 | 能力 |
|---|---|---|
| pymupdf (fitz) | 文本提取、字体样式(标题层级/粗体/等宽字体)、表格检测(find_tables())、图片提取并上传 S3、代码块检测、段落边界分析 | |
| DOCX | python-docx | 段落样式映射(Heading 1-6 → #-######)、内联格式(粗体/斜体 → **/*)、表格 → Markdown 表格、嵌入图片提取 |
| XLSX | openpyxl | 工作表 → Markdown 表格、合并单元格处理 |
8.4 Markdown → PDF 导出
pdf_export_service.py 基于 weasyprint 实现专业 PDF 导出:
- 标题 h1-h6 层级渲染
- 代码块带语法高亮背景
- Markdown 表格自动排版
- 图片从 S3 下载嵌入
- 粗体、斜体等内联样式保留
8.5 WebSocket 实时通知
兼容 SockJS 传输协议的 WebSocket 端点,支持实时推送审核通知、系统消息等,30 秒心跳保持连接活跃。
8.6 多 AI 模型适配
通过适配器模式统一接入多个 LLM 提供商(通义千问、DeepSeek),4 级降级策略保障可用性:主模型 → 重试 → 备用模型 → 兜底响应。
九、快速开始
9.1 环境要求
| 组件 | 版本 | 说明 |
|---|---|---|
| Python | >= 3.12 | 推荐 3.13 |
| UV | 最新版 | Python 包管理器 |
| Docker Desktop | 最新版 | 运行基础设施容器 |
9.2 启动步骤
# 1. 进入项目目录
cd knowledge-base-python

# 2. 启动基础设施(MySQL、Redis、ES、MongoDB、Neo4j、MinIO、RabbitMQ)
docker compose up -d

# 3. 创建数据库(9 个 MySQL 库)
docker exec -i kb-mysql mysql -uroot -proot123456 < sql/00_create_databases.sql

# 4. 配置环境变量
cp .env.example .env
# 编辑 .env 文件,修改数据库密码、Redis/ES/Mongo 地址等

# 5. 安装 Python 依赖
uv sync
uv pip install pymupdf

# 6. 执行数据库迁移(建表)
uv run alembic upgrade head

# 7. 启动后端服务
uv run uvicorn main:app --host 0.0.0.0 --port 8080 --reload
9.3 验证
浏览器打开 http://127.0.0.1:8080/doc.html,能看到 Swagger API 文档即表示启动成功。
十、与 Java 后端对比
本项目与同一系统的 Java(Spring Cloud)后端在 API 层面完全兼容,共用同一套数据库和基础设施。两者定位不同:
| 维度 | Java 后端 | Python 后端 |
|---|---|---|
| 框架 | Spring Boot 3.2 + Spring Cloud 2023.0 | FastAPI + Uvicorn |
| 架构 | 微服务(8 个独立进程 + Nacos 注册中心) | 模块化单体(单进程,APIRouter 拆分) |
| 端口 | 各服务独立端口(8080-8089) | 统一 8080 端口 |
| API 端点 | 约 197 个 | 一一对应,路径完全兼容 |
| ORM | MyBatis Plus | SQLAlchemy 2.0 Async |
| 数据库 | MySQL × 9 + Mongo + ES + Neo4j | 同一套 Schema,完全复用 |
| 认证 | JWT + Spring Security | JWT + 自定义中间件 |
| 密码加密 | BCrypt | BCrypt(完全兼容,Token 可互通) |
| 消息队列 | RabbitMQ(Spring AMQP) | RabbitMQ(aio-pika) |
| 部署 | 每个服务独立 JAR | 单进程 uvicorn 启动 |
| 启动速度 | JVM 冷启动 30s+ | Python 冷启动 < 5s |
| 内存占用 | 每服务 512MB+,总计 4GB+ | 单进程 200-500MB |
| PDF 解析 | Apache PDFBox + Tika | pymupdf |
| DOCX 解析 | Apache POI | python-docx |
| XLSX 解析 | Apache POI | openpyxl |
| PDF 导出 | Apache PDFBox | weasyprint |
| 视频转码 | FFmpeg | 规划中 |
| PPTX 解析 | Apache POI | 规划中 |
选择建议:
- 需要完整功能集和视频处理能力 → Java 后端
- 追求部署简单、快速迭代、低资源占用 → Python 后端
- 两个后端可同时运行,共享同一套数据库,前端切换 API 地址即可
十一、系统效果截图
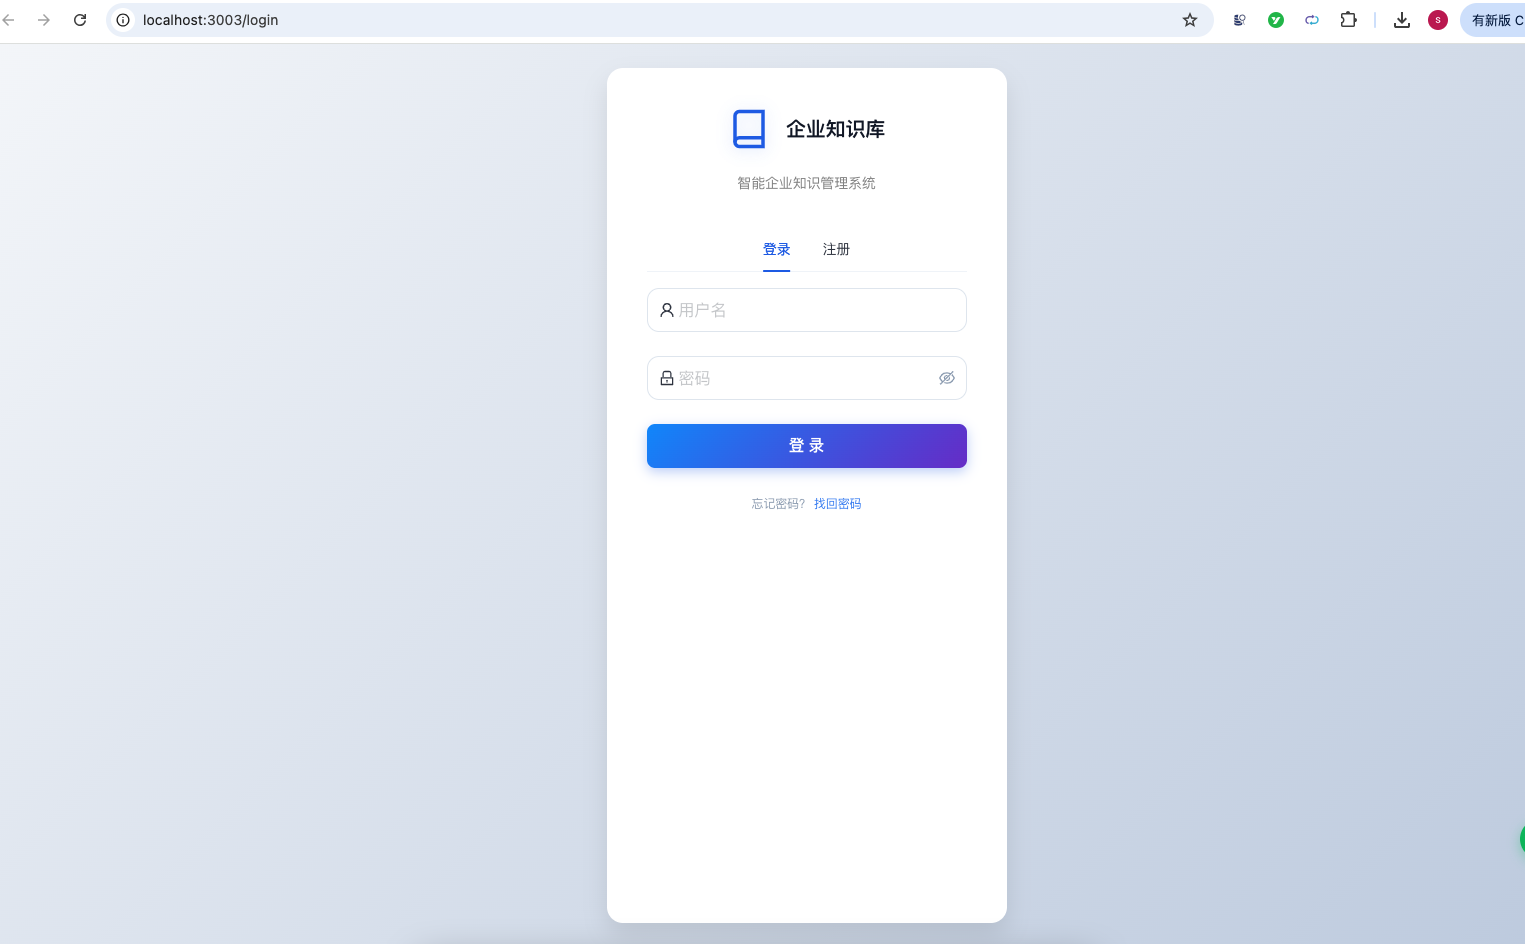
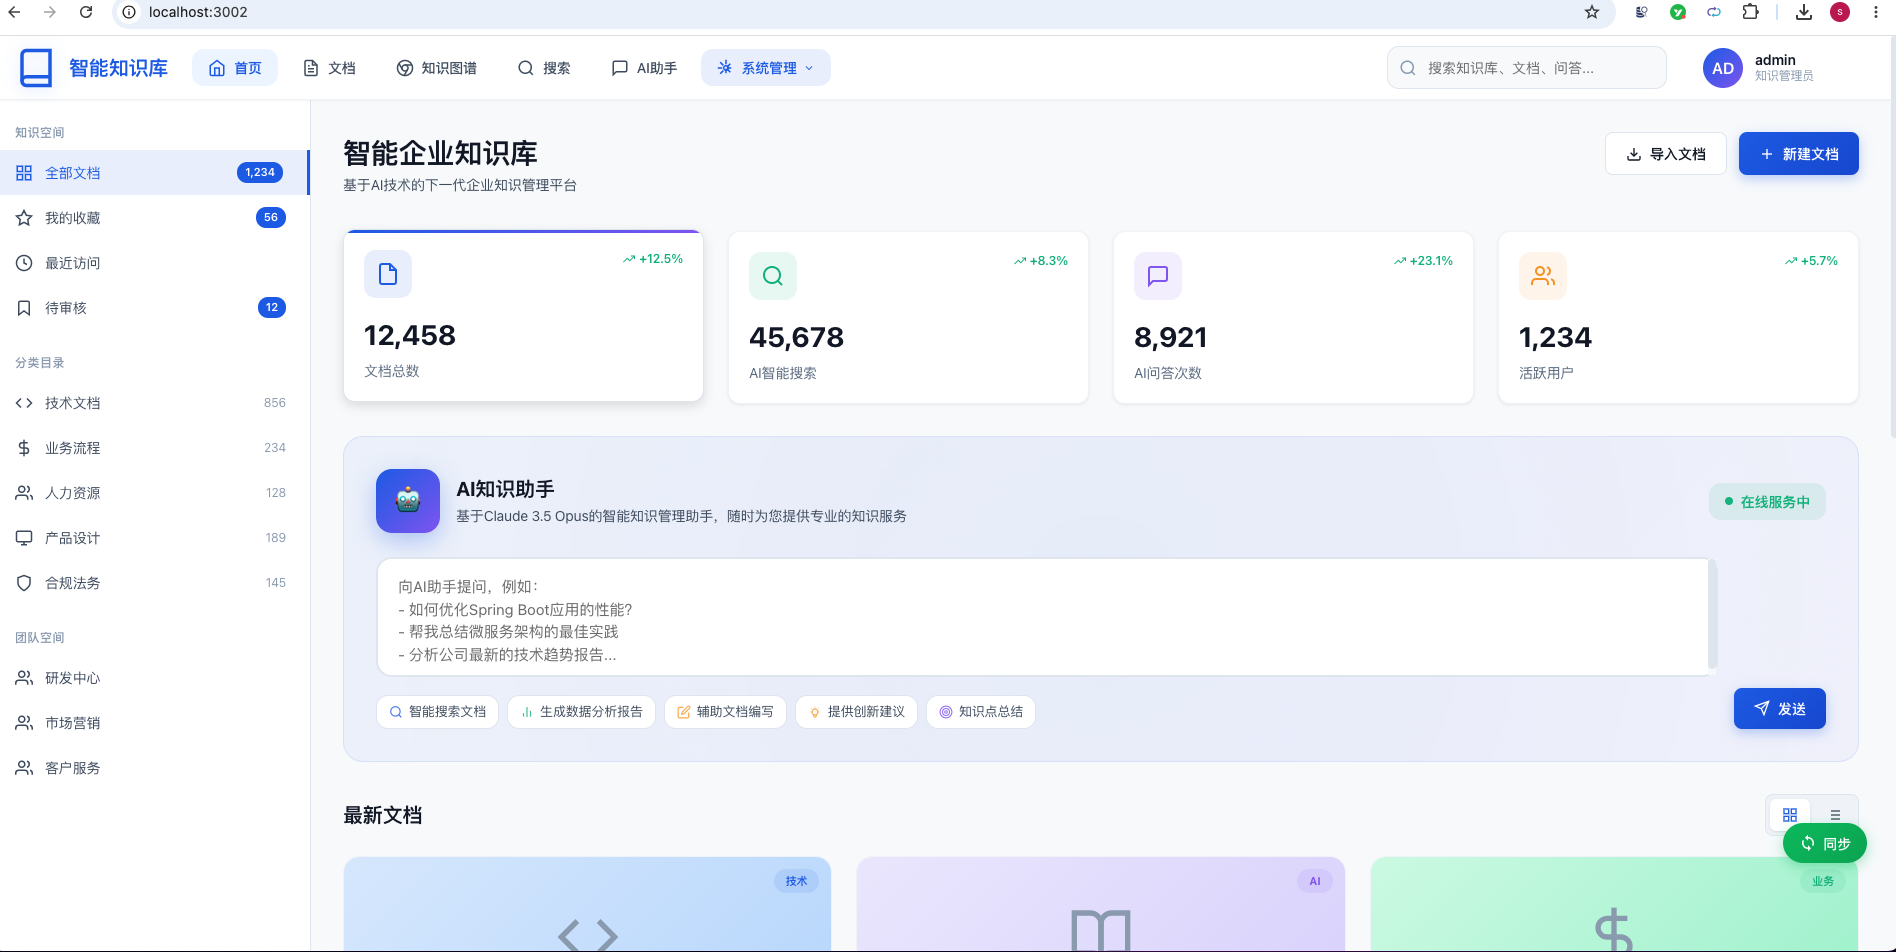
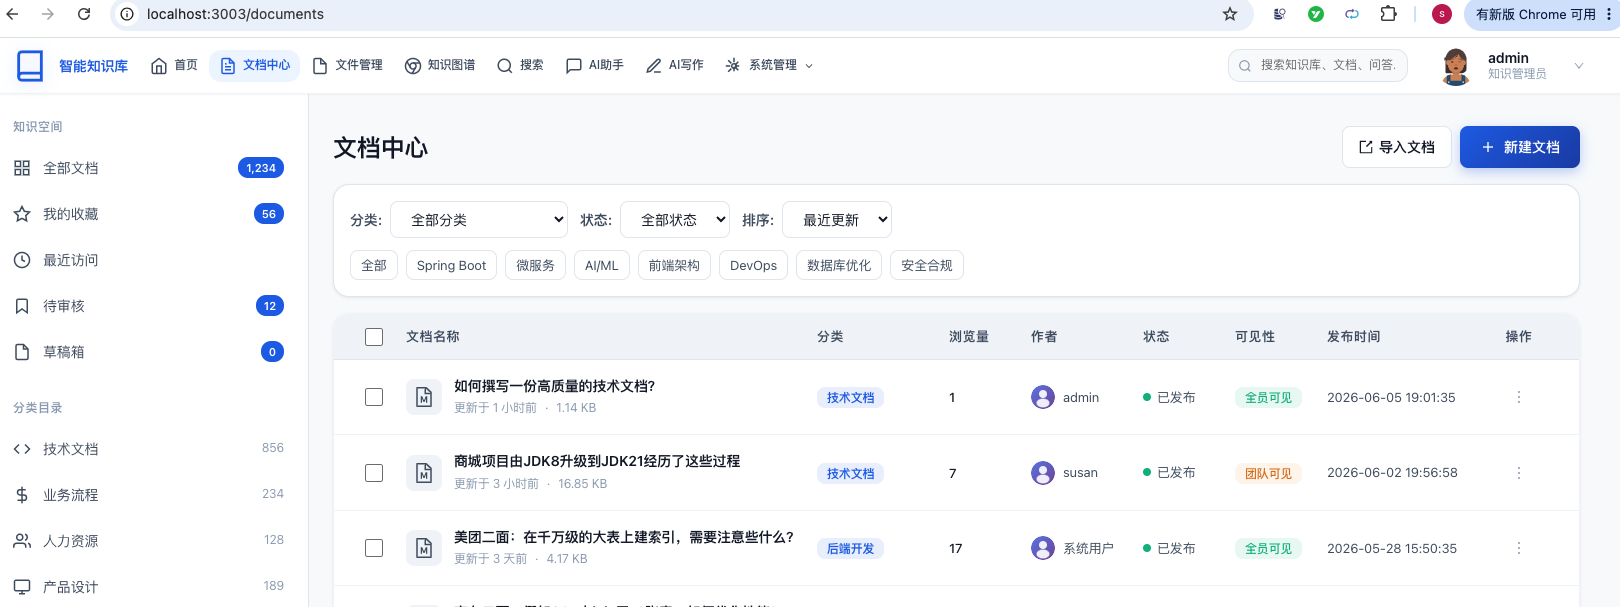
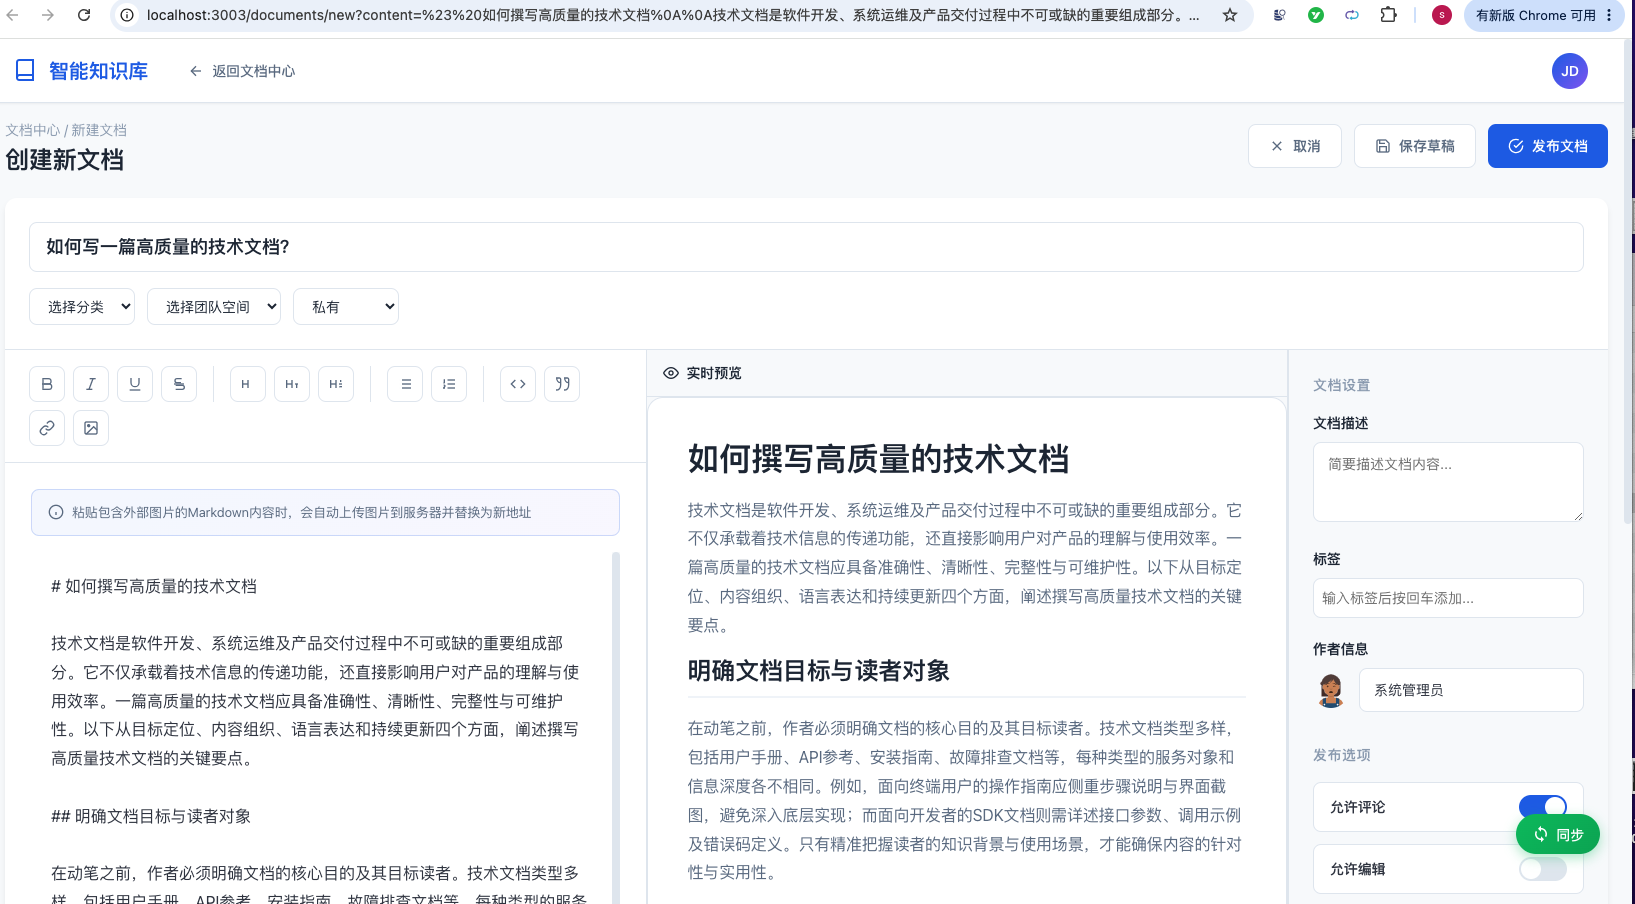
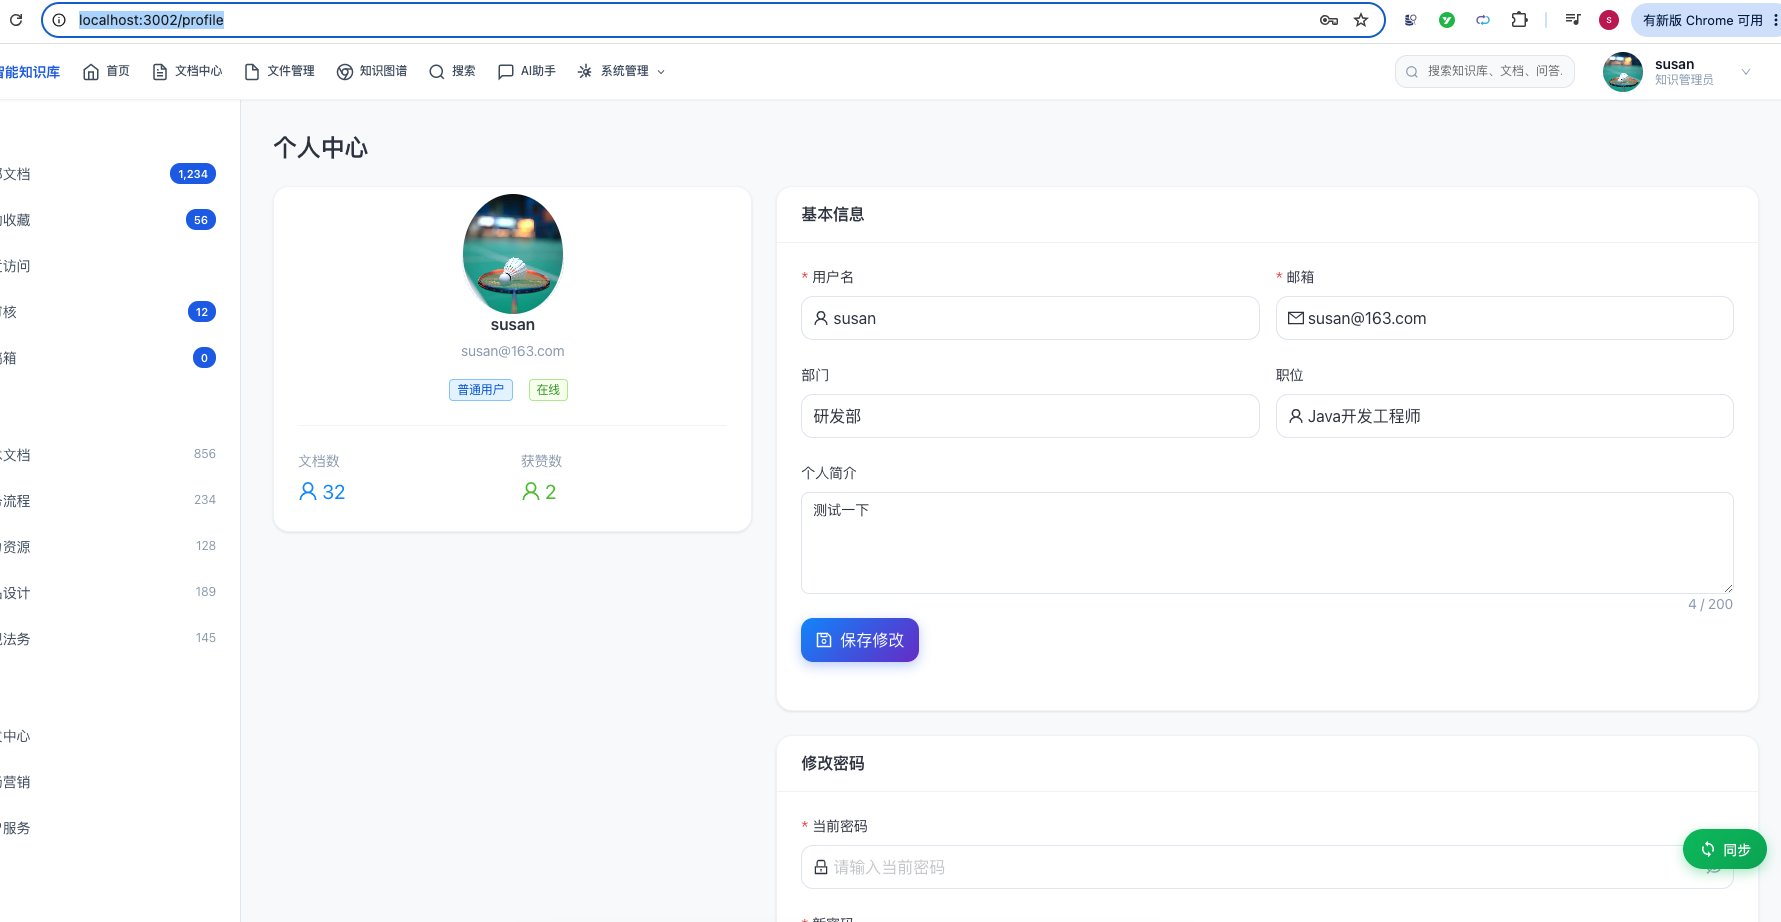
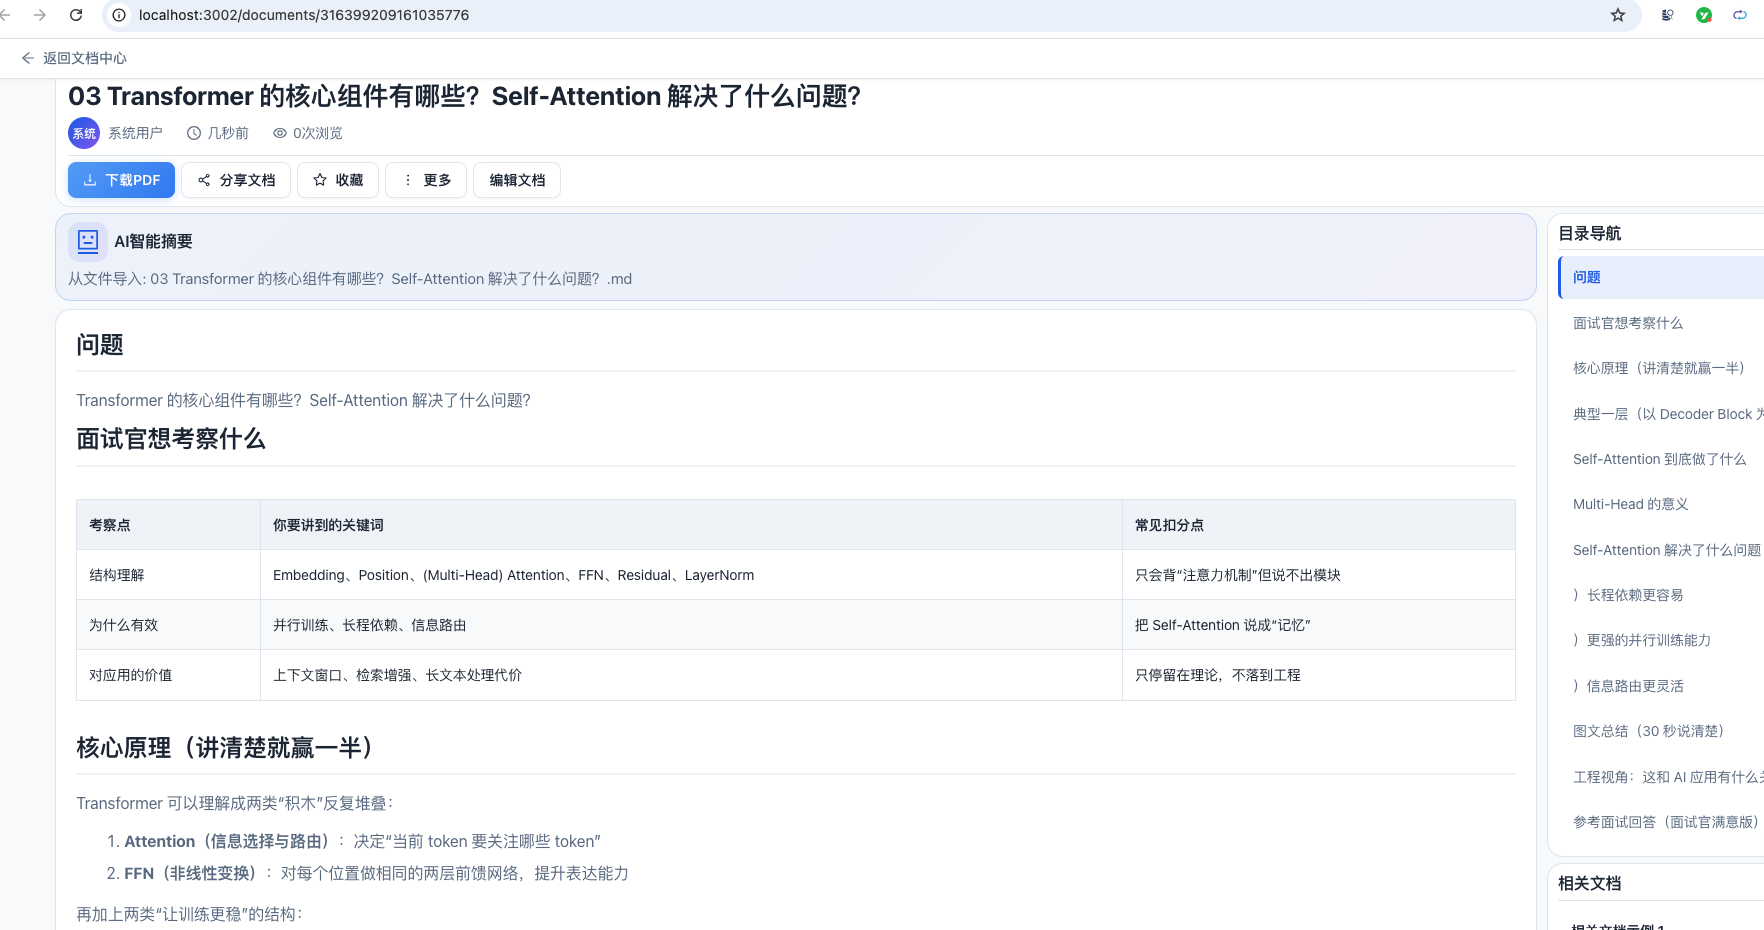
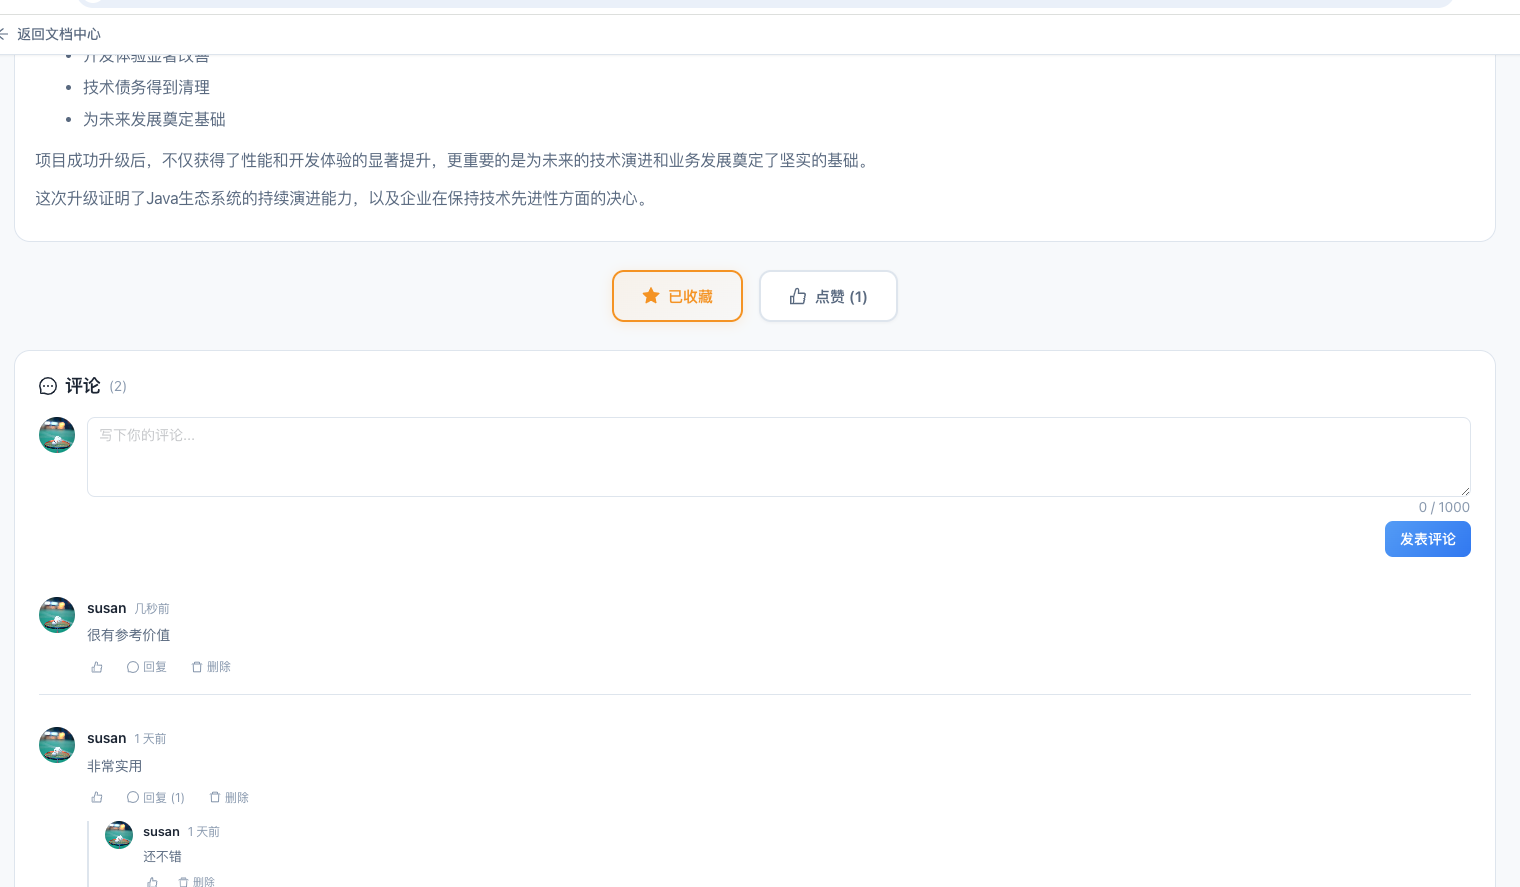
下面全部是系统实际运行截图,展示后端已经完整实现的业务能力。
文档功能
文档管理、上传、预览、分类与协作等日常操作界面。
知识图谱
Neo4j 知识图谱与 KAG 关系推理的可视化界面。
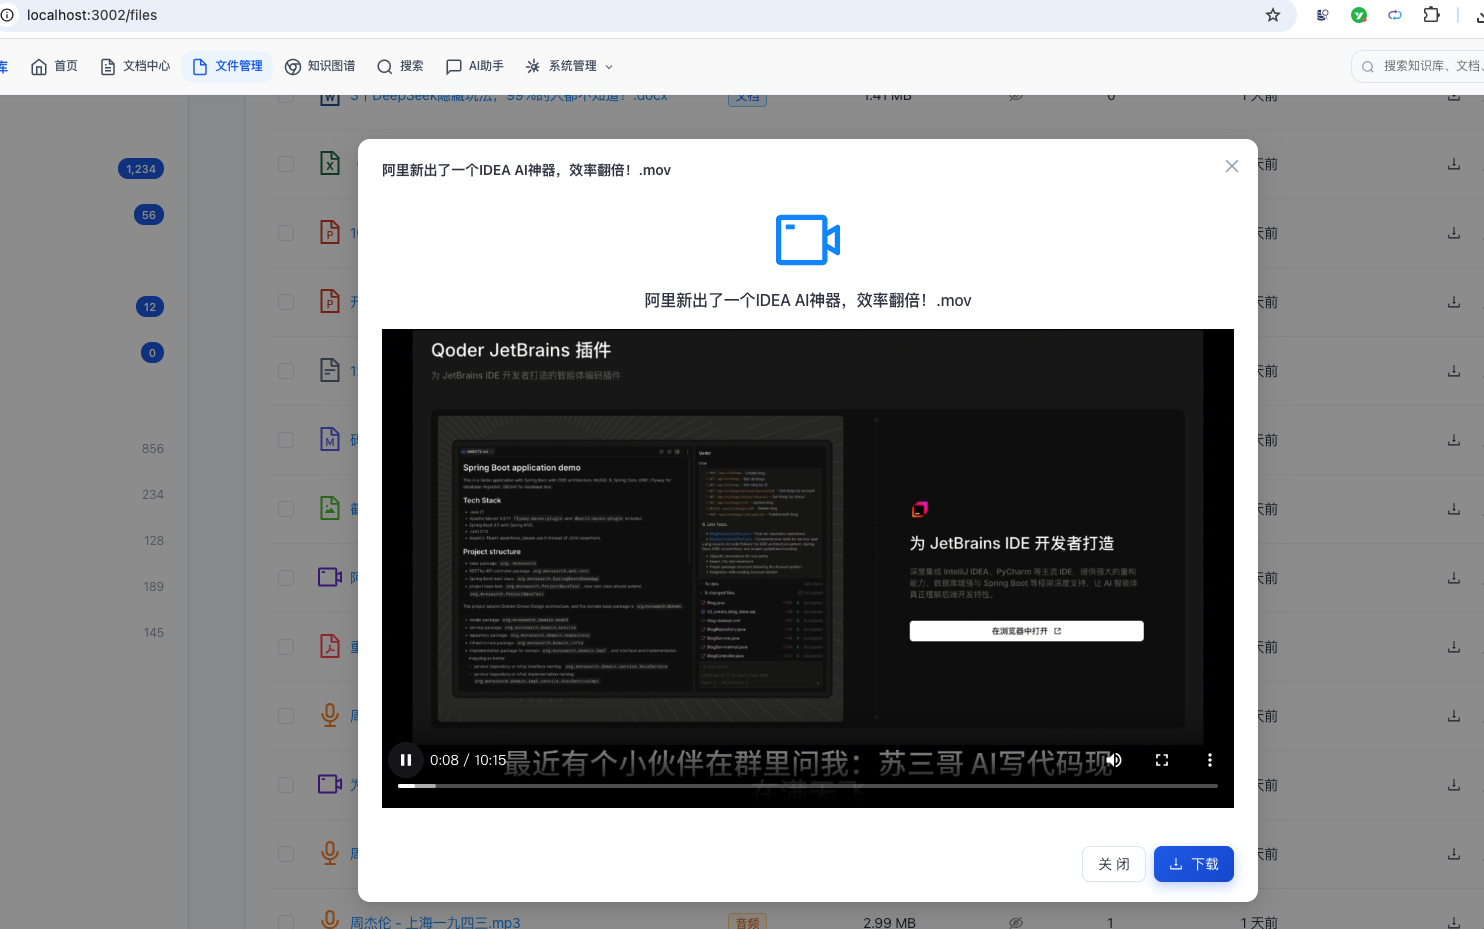
多类型文件支持
支持 PDF、Word、PPT、Excel、Markdown、音频、视频等多种格式的上传与预览。
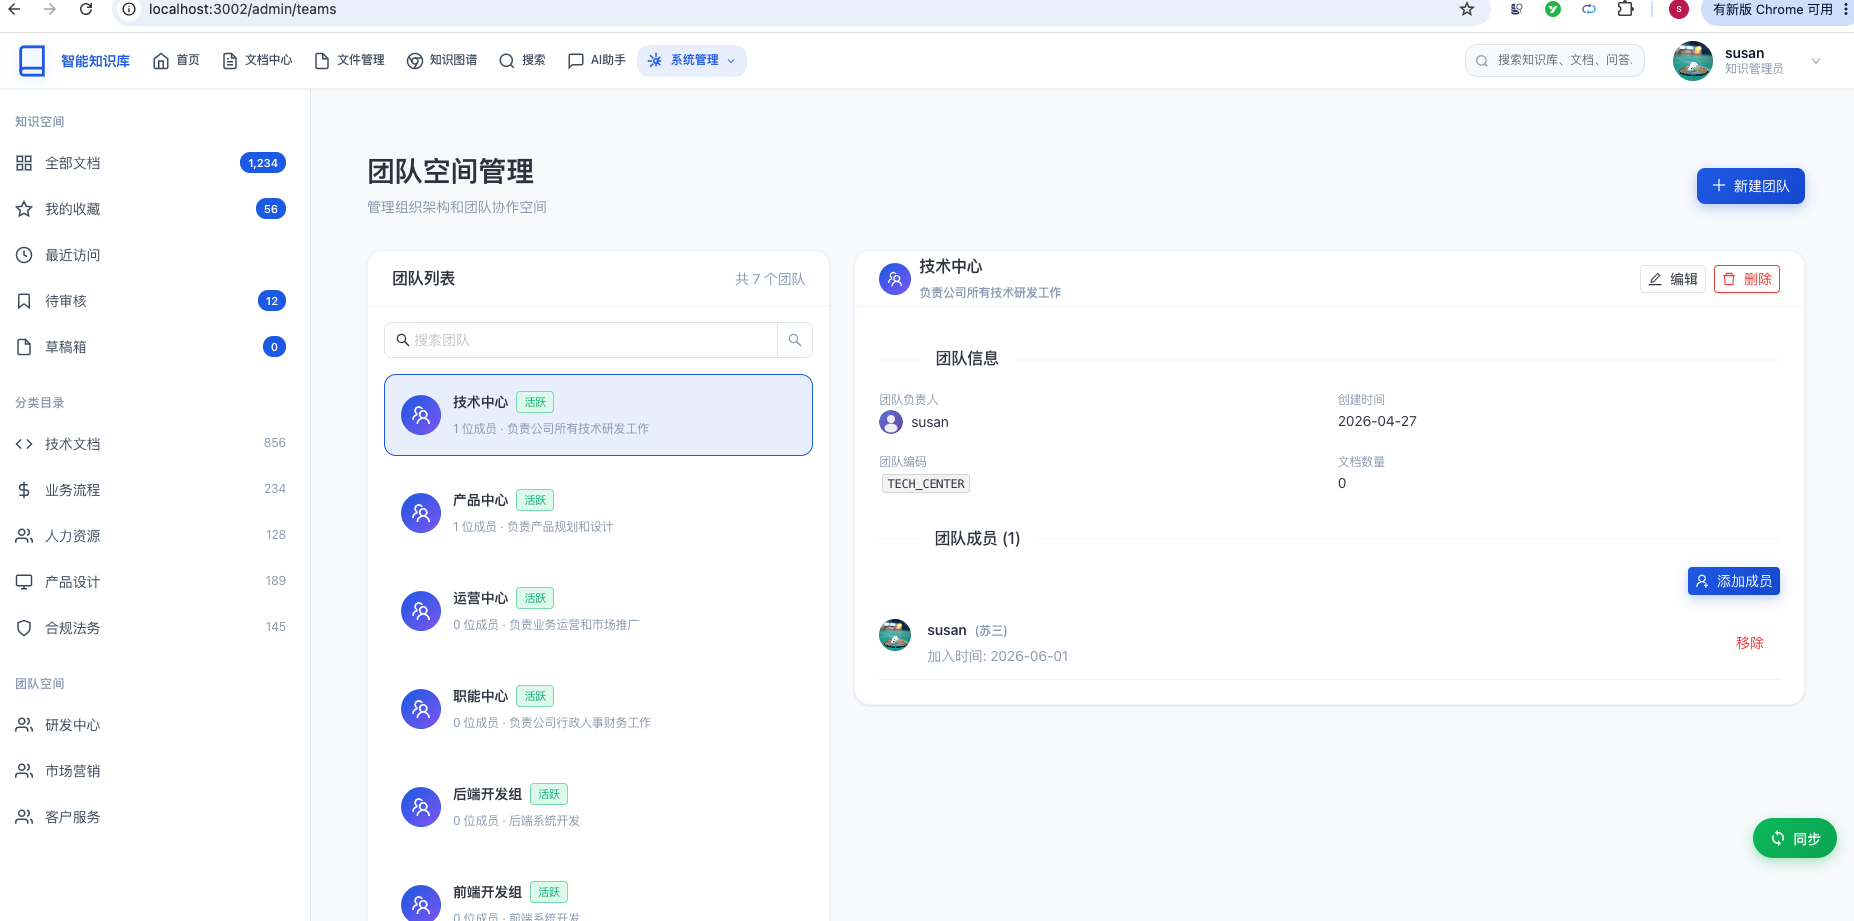
团队空间
按团队隔离的知识空间与成员权限管理。
最近缺项目经历想快速提升项目实战能力(包含多个AI项目),或者最近找工作,或者想学习AI的小伙伴,可以看看下面👇🏻的这个链接(或许真的能够帮到你)。
