Spring Boot 4.0 整合 PostgreSQL:JSONB、索引与全文检索
前言
订单经常需要保存渠道、活动、设备、来源等字段。为每个营销活动加一列,表结构会越来越碎;全部塞进一个普通文本列,又失去查询和索引能力。
PostgreSQL 的 JSONB 适合低频变化、结构不固定的附加属性。全文检索则适合在商品名、描述等文本中快速找词。
本章实现组合查询:
租户 = demo
AND 商品文本匹配“机械键盘”
AND metadata.channel = web配套源码:dvsusan/spring-boot4-demo。
最终结果
请求:
curl "http://localhost:8080/api/v1/db/orders/search?keyword=机械键盘&channel=web" \
-H "X-Tenant-Id: demo"返回匹配订单,channel 来自 JSONB:
{
  "code": "0",
  "message": "success",
  "data": [
    {
      "orderNo": "PO8F3C1024A8D91F",
      "customerNo": "C1001",
      "amount": 199.00,
      "status": "CREATED",
      "channel": "web",
      "metadata": "{\"channel\": \"web\", \"campaign\": \"autumn\"}"
    }
  ]
}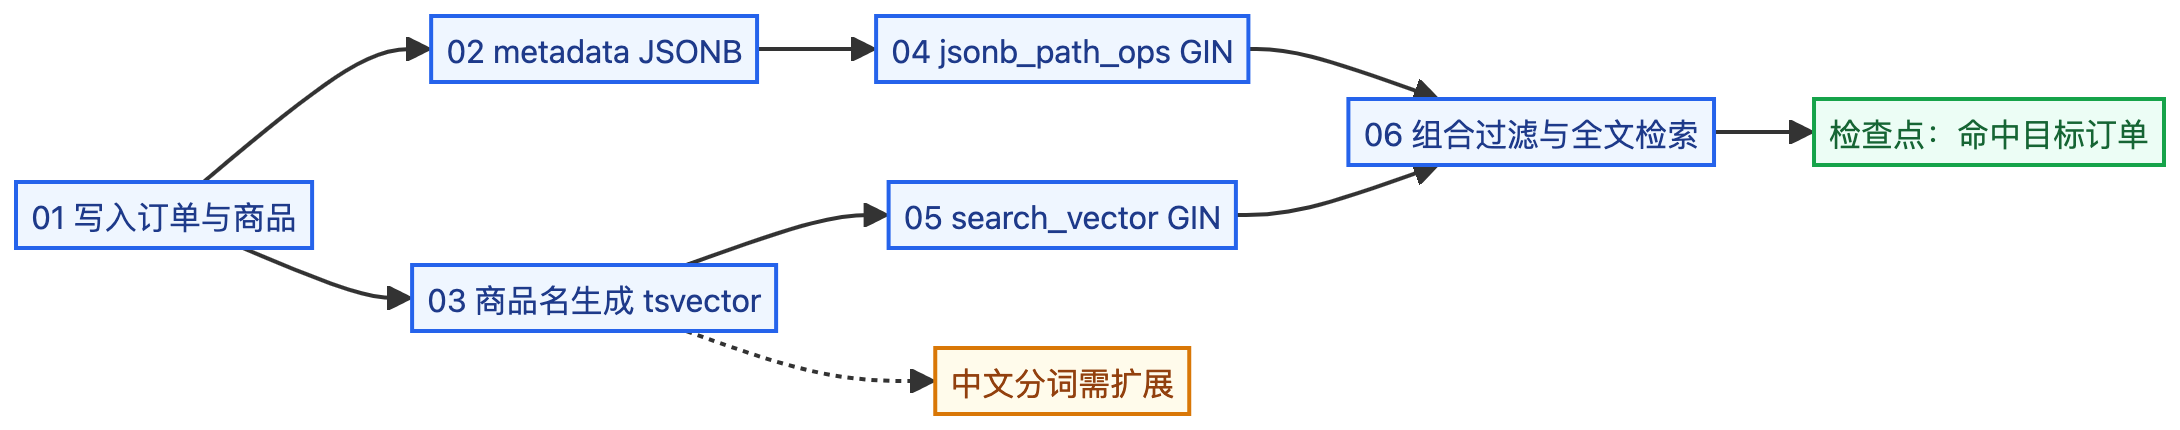
图 1:JSONB 与全文向量分别建索引,最终在同一条查询里组合。
第 1 步:选择 JSONB 而不是普通字符串
JSONB 会解析输入并移除无意义空白、重复键,可以:
- 用
->>提取文本字段。 - 用
@>判断是否包含结构。 - 用 GIN 索引加速匹配。
不要把订单金额、状态、客户编号这类核心字段放进 JSONB。它们需要外键、唯一约束、范围检查和稳定类型,仍然应该使用普通列。
第 2 步:迁移增加 JSONB 列
-- 默认空对象,避免旧代码插入 null 后还要处理三值逻辑。
ALTER TABLE purchase_orders
    ADD COLUMN metadata JSONB NOT NULL DEFAULT '{}'::jsonb;

-- jsonb_path_ops 对常见包含查询更紧凑。
CREATE INDEX idx_order_metadata_gin
    ON purchase_orders USING GIN (metadata jsonb_path_ops);
索引不是列。已有大表执行 CREATE INDEX 可能锁写,生产要先评估并发创建和窗口时间。
第 3 步:用 JPA 映射 JSON 对象
// Hibernate 使用 JSON JDBC 类型在 Map 与 PostgreSQL JSONB 之间转换。
@JdbcTypeCode(SqlTypes.JSON)
@Column(
        name = "metadata",
        nullable = false,
        columnDefinition = "json"
)
private Map<String, String> metadata;
@JdbcTypeCode(SqlTypes.JSON) 让 Hibernate 通过 JSON JDBC 类型读写 Map。PostgreSQL 实际列使用 JSONB,通过 Flyway 管理;Hibernate 不负责改结构。
JSONB 适合少量额外属性。若每次查询都要展开十几个 JSON 字段,应重新评估领域模型。
第 4 步:生成全文向量
-- 生成列由数据库自动维护,应用不会忘记更新。
ALTER TABLE order_items
    ADD COLUMN search_vector TSVECTOR
        GENERATED ALWAYS AS (
            to_tsvector('simple', product_name)
        ) STORED;

CREATE INDEX idx_order_item_search_gin
    ON order_items USING GIN (search_vector);
Tsvector 保存可检索词项。GIN 索引适合多值文本查询。
这里使用 PostgreSQL simple 配置:它主要做小写和基础断词,不等同于中文分词。中文业务量大时,应使用 zhparser、pg_jieba 或成熟搜索引擎,并测试召回质量。
第 5 步:把过滤写入 MyBatis
Mapper 方法:
// keyword 和 channel 都允许为空,XML 动态拼接过滤条件。
List<OrderSearchRow> search(
        @Param("tenantId") String tenantId,
        @Param("keyword") String keyword,
        @Param("channel") String channel,
        @Param("limit") int limit
);
SQL:
<!-- EXISTS 防止一个订单因多个命中商品而重复出现。 -->
<select id="search" resultMap="orderSearchMap">
    SELECT order_row.order_no,
           customer_row.customer_no,
           order_row.amount,
           order_row.status,
           order_row.metadata ->> 'channel' AS channel,
           order_row.metadata::text AS metadata,
           order_row.created_at
    FROM purchase_orders order_row
    JOIN customers customer_row
      ON customer_row.id = order_row.customer_id
    WHERE order_row.tenant_id = #{tenantId}
    <if test="keyword != null and keyword != ''">
        AND EXISTS (
            SELECT 1
            FROM order_items item_row
            WHERE item_row.order_id = order_row.id
              AND item_row.search_vector
                  @@ plainto_tsquery('simple', #{keyword})
        )
    </if>
    <if test="channel != null and channel != ''">
        AND order_row.metadata ->> 'channel' = #{channel}
    </if>
    ORDER BY order_row.created_at DESC
    LIMIT #{limit}
</select>
使用 EXISTS 避免一个订单有多个匹配商品时产生重复订单行。所有动态条件仍使用 #{} 参数。
第 6 步:暴露检索接口
// 搜索返回量必须有服务端上限。
@GetMapping("/search")
public ApiResponse<List<OrderSearchRow>> search(
        @RequestHeader(name = "X-Tenant-Id", defaultValue = "demo")
        String tenantId,
        @RequestParam(required = false) String keyword,
        @RequestParam(required = false) String channel,
        @RequestParam(defaultValue = "20")
        @Min(1)
        @Max(100)
        int limit
) {
    return ApiResponse.success(orderService.search(
            tenantId,
            keyword,
            channel,
            limit
    ));
}
limit 必须有上限。搜索接口最容易被脚本高频调用,不限制返回量会放大数据库和网络成本。
第 7 步:写入一条可搜索订单
先准备库存:
curl -X PUT \
  "http://localhost:8080/api/v1/db/inventory/P1001?quantity=10"
创建:
curl -X POST "http://localhost:8080/api/v1/db/orders" \
  -H "Content-Type: application/json" \
  -d '{
    "customerNo":"C5001",
    "customerName":"搜索测试客户",
    "items":[
      {"productId":"P1001","productName":"机械键盘","quantity":1,"unitPrice":199.00}
    ],
    "metadata":{"channel":"web","campaign":"autumn"}
  }'
然后调用前面的搜索接口。可以分别省略 keyword 或 channel,观察动态条件如何组合。
第 8 步:检查执行计划
进入 PostgreSQL:
docker compose exec postgres \
  psql -U spring_boot4 -d spring_boot4
执行:
-- 查看查询是否使用 GIN 索引,以及实际行数和耗时。
EXPLAIN ANALYZE
SELECT order_row.order_no
FROM purchase_orders order_row
WHERE order_row.tenant_id = 'demo'
  AND order_row.metadata ->> 'channel' = 'web';
小表可能选择顺序扫描,这是优化器根据成本做出的合理决定。只有数据量和选择性接近生产时,执行计划才有参考价值。
索引也可能失效:
-- 对字段做函数运算后,普通字段索引可能无法直接使用。
WHERE LOWER(order_row.status) = 'created';
这类查询应增加表达式索引,或调整 SQL 让条件可索引。
常见问题排查
| 现象 | 常见原因 | 处理方式 |
|---|---|---|
| JSON 字段只能当字符串处理 | 列类型用了 TEXT | 改为 JSONB 并使用 JSON 运算符 |
| 查询 JSON 很慢 | 没有匹配的 GIN 索引 | 检查查询操作符与索引类型 |
| 全文检索无法命中中文 | 缺少中文分词扩展 | 安装分词器或改用搜索引擎 |
| 订单结果重复 | 一对多关联直接返回匹配商品 | 使用 EXISTS 或先去重 |
| 生产建索引阻塞写入 | 普通 CREATE INDEX 锁表 | 使用并发建索引和低峰窗口 |
| 小表没走索引 | 数据太少,顺序扫描更便宜 | 用生产规模数据做计划验证 |
本章小结
PostgreSQL 高级能力解决的是“查询模型”:
- JSONB 存少量弹性字段。
- GIN 索引加速 JSON 和全文条件。
- 生成列减少应用维护向量的一致性问题。
- 组合查询必须检查执行计划。
下一章会处理单表继续增长后的分片路由与跨分片聚合。
练习题
增加活动时间范围:
- 在 metadata 中保存
campaignStart和campaignEnd。 - 查询当前有效活动订单。
- 比较表达式索引与将时间拆成正式列两种方案。
- 用真实数据量执行
EXPLAIN ANALYZE。
相关阅读:
13 个企业级实战项目 · 源码 + 教程 + 答疑
简历包装指导AI Agent 实战高并发·微服务Offer 导向持续更新3000+ 同行交流1V1 答疑3 天包退
覆盖高并发、微服务、分布式与 AI Agent:100万QPS短链、企业智能知识库、商城微服务、SaaS点餐、秒杀、刷题小程序、代码生成器、AI Agent 等。券后 ¥129(原价 ¥159),不满意 3 天包退。